Generasi video AI
Apa itu referensi ke video?
Referensi ke video, atau R2V, adalah generasi video AI yang membuat shot baru dari sebuah prompt dan satu atau beberapa gambar referensi karakter, produk, atau tempat. Berbeda dengan gambar ke video, tidak ada gambar yang menjadi frame: model menjaga apa yang ditunjukkan setiap referensi tetap dikenali, sementara ia memilih pembingkaian, pose, dan aksi yang dijelaskan prompt.
Oleh tim DreamBench. Diperbarui .
Sekilas tentang referensi ke video
Sekilas
- Input
- Sebuah prompt dan satu atau beberapa gambar: orang, makhluk, produk, tempat.
- Output
- Shot baru, biasanya 4 sampai 15 detik, tempat subjek dari referensi muncul.
- Ditetapkan olehmu
- Siapa dan apa yang ada di dalam shot, dan bagaimana penampilannya.
- Model yang menentukan
- Pembingkaian, pose, aksi, dan cahaya, dari prompt.
- Paling cocok untuk
- Karakter, produk, atau tempat yang sama di banyak shot.
- Kesulitan dengan
- Beberapa orang yang mirip, teks kecil di produk, dan referensi yang tersalin utuh.
Cara kerja referensi ke video
Referensi ke video bekerja dengan membiarkan model membaca gambarmu saat menghasilkan video, tanpa menempatkan satu pun di dalam klip. Setiap gambar menunjukkan rupa sesuatu; prompt menyebutkan apa yang terjadi. Model lalu menghasilkan setiap frame dari noise, seperti dalam teks ke video, sambil mempertahankan wajah, bentuk, dan warna yang ditunjukkan kepadanya.
Gambar referensi, masing-masing dengan nama
@miaKarakter
Wajah, rambut, dan mantelnya, sama di setiap panel.
@lampProperti
Bentuk dan warnanya, dari depan dan dari tiga perempat.
@atticLokasi
Ruangannya sendiri, kosong, agar tidak ada isinya yang tersalin tanpa sengaja.
Prompt menyebut mereka dengan namanya
@mia naik ke @attic saat senja, menemukan @lamp di bawah kain penutup lalu menyalakannya; kamera perlahan mendorong masuk ke wajahnya saat lampu menyala.
Shot baru yang dibuat model
Wide: ketiganya dalam satu frame
Close: wajah yang sama, sudut baru
Tidak ada referensi yang menjadi frame. Model mempertahankan siapa dan apa yang ditunjukkan setiap gambar, dan prompt menentukan di mana mereka berdiri, bagaimana mereka bergerak, dan bagaimana kamera melihat mereka.
Itulah bedanya dengan gambar ke video, tempat gambarmu menjadi frame pertama dan kamera mulai persis di sana. Dengan referensi, pembukanya pilihan model, jadi close-up, wide shot, dan sudut kebalikan semuanya bisa menampilkan orang yang sama. Ini cara paling umum untuk mendapatkan karakter yang konsisten di seluruh shot sebuah film.
Di balik layar: ke mana gambar referensi masuk
Model terbuka VACE, yang menamai tugas ini R2V, mendokumentasikan satu desain. Setiap gambar referensi dikompresi oleh encoder yang sama dengan videonya dan ditempatkan di depan frame-frame klip, ditandai sebagai frame yang dipertahankan. Model menghasilkan klip di sampingnya, dan frame referensi dibuang setelah decoding.
Karena referensi berada di sekuens yang sama dengan frame-frame, attention yang menjaga frame 10 selaras dengan frame 11 juga menjaga keduanya selaras dengan gambarmu. Tidak ada bagian metode ini yang menyalin pose atau latar belakang gambar: model belajar dari pasangan data latih bagian mana yang dipertahankan.
Makalah Phantom menyebut keseimbangan yang menjadi kunci tugas ini: teks dan gambar mengarahkan bersama. Saat gambar terlalu dominan, isinya ikut bocor, seperti pose, latar belakang, atau cahaya fotonya; dengan beberapa subjek, model bisa mencampuradukkan mereka.
Cara menulis prompt untuk referensi ke video
- Beri nama setiap referensi dan sebut di tempat ia beraksi: “@mia mengangkat @lamp dari rak” memberi tahu model gambar mana yang memerankan bagian mana.
- Jelaskan aksi, kamera, dan cahayanya, bukan penampilan subjek: gambar sudah memberikannya, dan deskripsi kedua bisa bertentangan dengannya.
- Beri setiap gambar satu tugas. Foto seorang perempuan yang memegang lampu berisi dua subjek dalam satu gambar; potong fotonya, atau model mungkin menjaga keduanya tetap bersama.
- Sebutkan di mana shot berlangsung meski ada referensi lokasi, agar model tahu itu latarnya dan bukan backdrop yang ditempel.
Gambar ke video, frame pertama dan terakhir, atau referensi ke video?
Ketiganya menerima gambar, dan memakainya dengan cara berbeda. Pertanyaannya: apakah gambarmu harus menjadi frame klip, atau deskripsi sesuatu di dalamnya.
| Yang dilakukan gambarmu | Yang tetap persis milikmu | Cocok untuk | |
|---|---|---|---|
| Gambar ke video | Menjadi frame pertama | Frame pembuka, sama persis per piksel | Menganimasikan foto, foto produk, atau frame yang sudah didesain |
| Frame pertama dan terakhir | Menjadi frame pertama dan frame terakhir | Kedua ujung shot | Transisi, pengungkapan, sebelum dan sesudah |
| Referensi jadi video | Menggambarkan subjek atau tempat yang ada di dalam shot | Penampilannya, bukan di mana atau bagaimana mereka muncul | Karakter, produk, atau tempat yang sama di banyak shot |
| Teks ke video | Tanpa gambar: hanya kata-kata | Hanya apa yang dikatakan kata-kata itu | Ide, suasana, dan b-roll |
Mana yang sebaiknya kupakai? Jika klip harus dibuka dengan frame yang kamu punya, pakai gambar ke video. Jika kamu butuh wajah atau produk yang sama di shot-shot yang masing-masing dimulai dari tempat baru, pakai referensi: kamera bisa mulai dari mana saja.
Apa yang ditetapkan setiap jenis gambar referensi
Referensi hanya berguna sejauh apa yang ditunjukkannya dengan jelas. DreamBench memintamu menandai setiap gambar sebagai salah satu dari empat jenis, karena masing-masing memberi tahu model hal yang berbeda:
| Isinya | Yang masih diputuskan model | Gambar yang cocok | |
|---|---|---|---|
| Karakter | Wajah, rambut, postur tubuh, dan pakaian | Pose, ekspresi, pembingkaian, dan cahaya | Satu orang, tajam dan pencahayaannya rata, wajahnya besar di frame, dengan latar polos |
| Makhluk | Bentuk tubuh, corak, dan warna | Cara ia bergerak, dan dari mana kita melihatnya | Hewan atau makhluknya utuh, dari samping, tanpa apa pun di depannya |
| Lokasi | Tata letak, penanda, dan material | Di mana kamera berdiri, dan siapa yang ada di sana | Tempatnya kosong, cukup lebar untuk menunjukkan yang penting, setinggi mata |
| Properti | Bentuk, warna, label, atau logo | Di mana posisinya, siapa yang memegangnya, dan dari sudut apa | Bendanya saja, dari depan, labelnya terbaca |
Produk dihitung sebagai properti. Logo juga, meski hurufnya adalah detail yang paling sulit dijaga model.
Gambar referensi bekerja dalam edit DreamBench sungguhan
Referensi mengarahkan edit sama seperti shot baru. Dalam edit Morph ini, instruksinya menyebut lembar karakter tiga kucing, sebuah ruang tamu, dan denah lantainya dengan nama, dan klipnya mempertahankan tariannya sementara kucing dan ruangannya berubah.
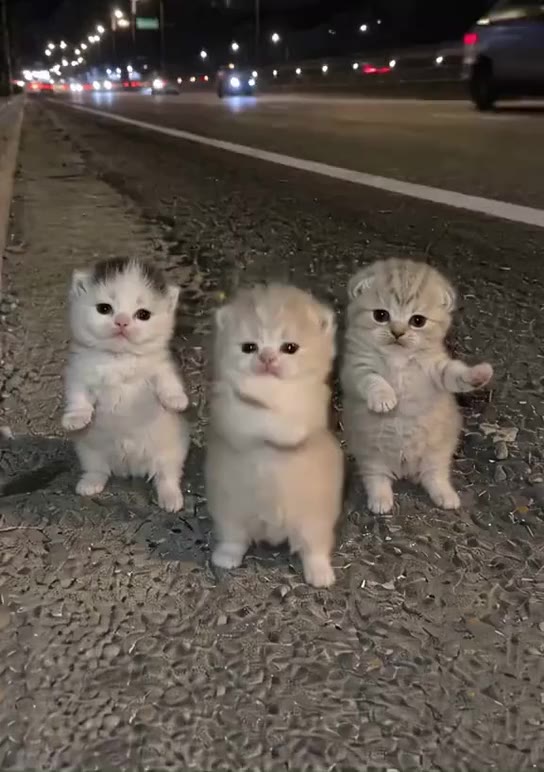 Asli
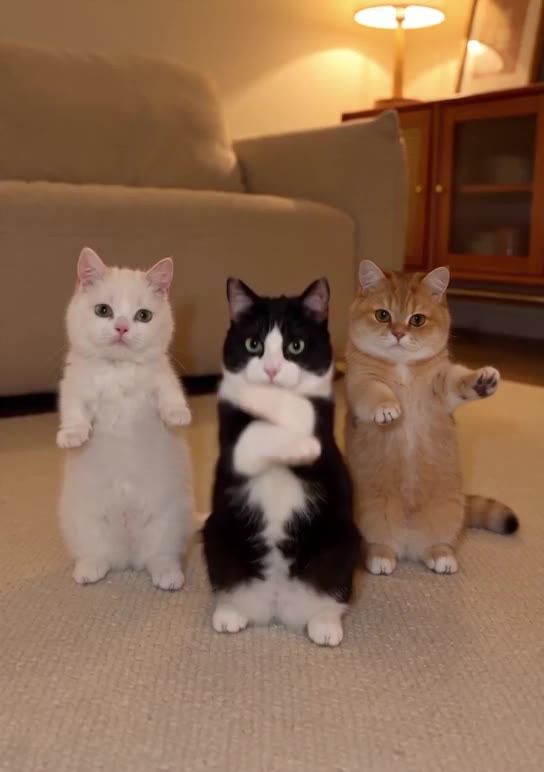 Dengan Morph
Ganti latar belakang menjadi @livingroom, dengan tata letak seperti @floorplan, tapi tukar 3 kucing dengan @yickshuncat, @oreo, dan @mango.
Ini video ke video dengan referensi, bukan referensi ke video, karena gerakannya berasal dari klip sungguhan. Referensi melakukan tugas yang sama di keduanya: menyebutkan siapa dan apa yang muncul, tidak lebih.
Ingredients, Elements, subject reference: gagasan yang sama dengan nama lain
Setiap pembuat model menamai fitur ini dengan caranya sendiri, dan masing-masing menetapkan batas jumlah gambarnya sendiri. Isi halaman resmi mereka saat kami membacanya:
| Nama dari pembuatnya | Yang diterima | |
|---|---|---|
| Veo 3.1 (Google) | Ingredients to video | Hingga 3 gambar referensi karakter, objek, atau adegan |
| Kling (Video 3.0 Omni dan O1) | Elements | Satu element berisi 2 sampai 4 gambar satu subjek; hingga 7 gambar atau element dalam satu generasi, atau 4 jika video juga diberikan |
| Vidu Q2 | Reference to video | 1 sampai 7 gambar (1 sampai 3 di Vidu 2.0) |
| Seedance 2.0 | Multimodal reference | Hingga 9 gambar, 3 klip video, dan 3 klip audio |
| MiniMax S2V-01 | Subject reference | Satu gambar wajah seseorang |
Untuk apa orang memakai referensi ke video
- Film pendek dan serial dengan karakter yang sama di setiap adegan.
- Iklan produk: satu foto produk, banyak shot produk itu saat dipakai, labelnya tetap terjaga.
- Maskot dan karakter brand yang harus terlihat sama di setiap postingan.
- Memasukkan hewan peliharaan, mainan, atau karakter gambar ke adegan baru.
- Mempertahankan satu lokasi, toko atau apartemen, di semua shot yang terjadi di sana.
- Storyboard yang bergerak, dengan para pemeran yang sudah tampil sesuai casting-nya.
Di mana referensi ke video gagal
- Salin-tempel: pose, latar belakang, atau cahaya referensi terbawa utuh, sehingga setiap shot terlihat seperti fotonya. Latar polos dan cahaya yang rata membantu.
- Subjek tertukar: dua orang dengan postur dan warna yang mirip bisa bertukar wajah atau pakaian. Buat mereka berbeda, dan sebut masing-masing dengan namanya di tempat ia beraksi.
- Detail halus: teks kecil di label, huruf logo, dan kain bermotif dijaga kurang baik dibanding bentuk dan warna.
- Sisi yang tak terlihat: referensi wajah dari depan menyerahkan bagian belakang kepala kepada model. Lembar dengan beberapa tampilan memberinya lebih banyak yang bisa dijaga.
- Terlalu banyak gambar: setiap model hanya menerima sejumlah gambar per klip, dan lebih dari itu sebagian ditinggalkan.
- Pergeseran seiring waktu: shot yang panjang atau ramai tetap bisa kehilangan detail, kegagalan konsistensi temporal.
Kenapa karakterku tidak mirip referensiku? Biasanya gambarnya menunjukkan terlalu banyak sekaligus: wajah kecil, cahaya keras, orang lain, atau latar yang ramai. Pakai gambar subjek sendirian yang tajam, jangan jelaskan lagi penampilannya di prompt, dan buat shot-nya pendek.
Gambar referensi orang sungguhan: persetujuan dan aturannya
Referensi orang sungguhan bisa menempatkan orang itu di adegan yang tidak pernah ia jalani. Pakai wajahmu sendiri, atau wajah orang yang sudah setuju dengan penggunaan ini, dan beri label pada video yang bisa disangka rekaman asli.
- Ketentuan DreamBench meminta izin berdasarkan informasi yang memadai sebelum kemiripan wajah atau suara orang sungguhan digambarkan dengan AI, dan melarang penggambaran orang sungguhan tanpa izin, peniruan identitas, serta dukungan palsu.
- Setiap gambar yang diunggah diperiksa sebelum kredit apa pun terpakai: ketelanjangan, kekerasan berdarah, dan menyakiti diri sendiri ditolak, begitu juga orang fotorealistis yang tampak berusia di bawah 18 tahun.
- Seedance tidak menerima wajah manusia sungguhan. Referensi yang menampilkannya ditolak, dan DreamBench memberitahukannya serta menyarankan model video lain untuk adegan-adegan itu.
- Pembuat model juga menetapkan aturan sendiri: subject reference MiniMax, misalnya, hanya menerima satu gambar wajah seseorang.
Model video mana di DreamBench yang menerima gambar referensi
Setiap model video di DreamBench memakai referensimu. Di empat model, gambarnya dikirim ke model video bersama setiap klip. Di model lainnya, model gambar lebih dulu menggambar gambar diam pembuka klip dari gambar-gambar itu, lalu model video menganimasikan gambar diam tersebut:
| Gambar per klip | Cara gambarnya sampai ke klip | |
|---|---|---|
| Seedance 2.5 | Hingga 30 | Bersama klip itu sendiri; satu slot bisa berisi gambar diam pembuka klip |
| Seedance 2.0 | Hingga 9 | Bersama klip itu sendiri; satu slot bisa berisi gambar diam pembuka klip |
| Veo 3.1 | Hingga 3 | Bersama klip itu sendiri |
| Vidu Q2 | Hingga 7 | Bersama klip itu sendiri: Vidu Q2 merender hanya dari referensi |
| Kling 3.0, Wan, LTX-2.3, HappyHorse 1.1, Grok Imagine 1.5, MiniMax H3 | Hingga 6, lewat gambar diam pembuka | Model gambar menggambar gambar diam pembuka dari gambar-gambar itu; klipnya lalu dibuat sebagai gambar ke video |
Jika model sebuah klip menerima lebih sedikit gambar daripada yang dimiliki adegannya, unggahanmu sendiri didahulukan. Seedance 2.5 menerima paling banyak; Veo 3.1 paling sedikit, jadi adegan dengan banyak orang dan properti lebih cocok di Seedance, asalkan tidak ada yang berupa wajah sungguhan.
Cara DreamBench memakai gambar referensi
Di panel pembuatan, kamu mendeskripsikan filmnya dan menambahkan hingga 8 gambar referensi. Setiap gambar diberi nama dan tanda: karakter, makhluk, lokasi, atau properti. Namanya menjadi handle, sehingga brief bisa menyebutnya, seperti “@mia membuka kotak dan mengeluarkan @lamp”; mengetik @ di brief menampilkan daftar handle.
DreamBench lalu menggambar lembar referensi untuk setiap karakter, tempat, dan properti yang dibutuhkan film. Lembar yang dibuat dari gambarmu digambar dengan subjek persis seperti yang ditunjukkan gambar itu, dan gambar yang namanya menyebut dirinya sebuah lembar dipakai apa adanya.
- Lembar karakter: wajah dari dekat, seluruh tubuh dari depan dan belakang, dan tampilan tiga perempat, dengan wajah yang sama di setiap panel, di atas latar abu-abu polos.
- Lembar properti: bendanya dari depan dan dari sudut tiga perempat.
- Lembar lokasi: tempatnya saja, kosong tanpa orang dan properti, agar tidak ada yang tersalin darinya.
Setiap klip membawa lembar dari apa yang ada di dalamnya, dan DreamBench menulis prompt shot yang menyebutnya. Di Edit adegan, setiap adegan menampilkan referensinya: hapus satu, tambahkan lembar lain dari film itu, atau unggah milikmu sendiri, sampai sebanyak yang diterima model adegan tersebut.
Kamu juga bisa mulai dari sebuah alat. Setelah alat foto produk ke video membuat klip, Lanjutkan sebagai cerita membuka panel pembuatan dengan fotomu sebagai referensi @product dan brief yang menyebutnya.
4 gambar referensi pertama sudah termasuk dalam harga dasar video, dan setiap gambar setelahnya menambah harga lembar yang dibutuhkannya. Lembar yang kamu pilih dari film sebelumnya tidak menambah apa pun, karena dipakai apa adanya. Panel pembuatan menampilkan totalnya dalam kredit sebelum kamu menghasilkan video.
Pertanyaan
Apa arti R2V?
R2V adalah singkatan dari reference to video (referensi ke video): menghasilkan shot video baru dari prompt dan gambar referensi karakter, objek, atau tempat. T2V, teks ke video, dan I2V, gambar ke video, adalah nama mode umum lainnya.
Apa perbedaan gambar ke video dan referensi ke video?
Dalam gambar ke video, gambarmu menjadi frame pertama, jadi klip dibuka persis dengannya. Dalam referensi ke video, tidak ada gambar yang menjadi frame: model menjaga penampilan subjek dan memilih pembingkaian, pose, dan aksi baru, sehingga orang yang sama bisa muncul di wide shot dan close-up.
Apa itu ingredients to video di Veo?
Ingredients to video adalah nama dari Google untuk referensi ke video di Veo 3.1. Pengumuman Google pada Oktober 2025 menyebut kamu bisa memberi hingga 3 gambar referensi karakter, objek, atau adegan untuk memandu generasi, misalnya untuk menjaga karakter tetap sama di beberapa shot.
Apa itu Elements di Kling AI?
Elements adalah referensi tersimpan milik Kling: satu element berisi 2 sampai 4 gambar satu subjek, satu gambar utama dan hingga 3 tambahan, dan prompt menyebutnya dengan @. Panduan Kling mengizinkan hingga 7 gambar atau element dalam satu generasi Video 3.0 Omni atau O1, atau 4 jika video juga diberikan.
Berapa banyak gambar referensi yang bisa kupakai?
Tergantung modelnya: Veo 3.1 menerima hingga 3, Vidu Q2 hingga 7, dan Seedance 2.0 hingga 9, menurut halaman pembuatnya. Di DreamBench, satu film menerima hingga 8 gambarmu sendiri, dan setiap klip membawa sebanyak yang diterima modelnya, hingga 30 di Seedance 2.5.
Bisakah aku memakai fotoku sendiri sebagai referensi?
Bisa, di model yang menerima wajah sungguhan. Seedance tidak: model ini menolak referensi yang menampilkan wajah manusia sungguhan, jadi di DreamBench adegan seperti itu butuh model video lain. Pakai hanya wajah yang kamu punya izin untuk dipakai, dan foto orang di bawah 18 tahun ditolak.
Kenapa videoku menyalin latar belakang foto referensiku?
Model menimbang seluruh gambar, jadi latar belakang, pose, atau cahaya yang kuat bisa ikut terbawa seolah bagian dari subjek. Pakai gambar subjek sendirian dengan latar polos, dan jelaskan latarnya di prompt atau beri referensi lokasinya sendiri.
Bisakah aku menjaga karakter yang sama di beberapa shot?
Bisa. Itulah kegunaan utama referensi: gambar yang sama ikut di setiap shot, sehingga wajah dan pakaian tetap sama di setiap potongan. Di DreamBench, setiap karakter mendapat lembar dengan beberapa tampilan, dan setiap klip tempat karakter itu muncul membawanya.
Seperti apa gambar referensi yang bagus?
Satu subjek, tajam dan pencahayaannya rata, besar di frame, dengan latar polos, tanpa ada yang menutupinya. Untuk orang, wajah yang jelas dan gambar kedua seluruh tubuh membantu; untuk produk, tampilan dari depan dengan label yang terbaca.
Bisakah referensi berupa produk atau logo?
Bisa. Tandai sebagai properti dan sebut di prompt di tempat ia muncul. Bentuk dan warna paling terjaga; teks kecil di label dan huruf logo adalah tempat kesalahan pertama terlihat, jadi periksa sebelum kamu memakai klipnya.
Bisakah aku memakai gambar referensi untuk lokasi?
Bisa. Gambar sebuah tempat, ditandai sebagai lokasi, menjaga tata letak dan materialnya di setiap shot. Pakai gambar tempat itu tanpa orang dan produk, agar tidak ada yang berdiri di sana yang ikut tersalin ke adegan.
Apakah memakai gambar referensi lebih mahal?
Di DreamBench, 4 gambar referensi pertama sudah termasuk dalam harga dasar video, dan setiap gambar setelahnya menambah harga lembar yang dibutuhkannya; lembar yang dipilih dari film sebelumnya tidak menambah apa pun. Kamu membuat akun gratis dan memilih paket sebelum video pertama, dan panel pembuatan menampilkan totalnya sebelum kamu menghasilkan video.
Terkait
Alat DreamBench
Halaman model
- Seedance 2.5Ceritakan kisah pendek dalam satu klip hingga 30 detik, dipotong menjadi shot-shot yang terhubung, dengan suara yang dibuat bersama gambarnya.
- Seedance 2.0Ikuti karakter melalui dialog dan aksi dalam klip hingga 15 detik, dipandu gambar referensi.
- Veo 3.1Bentuk adegan realistis layar lebar atau vertikal dengan dialog dan suara, di Veo 3.1, Fast, atau Lite.
- Vidu Q2Hadirkan sekelompok karakter dalam satu adegan dari gambar referensi mereka, dalam klip hingga 10 detik.
- Kling 3.0Jadikan gerakan sebagai fokus, dari olahraga dan tari hingga kendaraan, dengan dialog lip-sync dalam 5 bahasa.
Ketentuan
- Gambar ke videoVideo AI yang dimulai dari gambar diam, gerakannya dihasilkan dari prompt.
- Teks ke videoAI yang mengubah prompt tertulis menjadi klip video, setiap frame dikarang dari kata-katanya.
- Konsistensi temporalSeberapa baik video AI menjaga segala sesuatu tetap sama dari frame ke frame, tanpa kedipan atau pergeseran.
- Frame pertama dan terakhirVideo AI yang dibuka dengan satu gambar dan diakhiri gambar lain, dengan gerakan di antaranya dihasilkan oleh model.
- Konsistensi karakterMenjaga karakter tetap dikenali sebagai orang yang sama di setiap shot video AI, bukan hanya di dalam satu klip.
Sumber
- VACE: All-in-One Video Creation and EditingarXiv, dibaca pada
- Phantom: Subject-consistent video generation via cross-modal alignmentarXiv, dibaca pada
- Memperkenalkan Veo 3.1 dan kemampuan kreatif baru di Gemini APIGoogle, dibaca pada
- Panduan Pengguna Kling Element LibraryKling AI, dibaca pada
- Dokumentasi API Vidu: reference to videoVidu, dibaca pada
- Seedance 2.0: Advancing Video Generation for World ComplexityarXiv, dibaca pada
- Referensi API MiniMax: generasi video subject-referenceMiniMax, dibaca pada
DreamBench adalah platform independen dan tidak berafiliasi dengan atau didukung oleh perusahaan yang disebutkan di halaman ini.