Generasi video AI
Apa itu konsistensi karakter di video AI?
Konsistensi karakter adalah seberapa baik video AI menjaga karakter yang sama tetap terlihat sebagai orang, makhluk, atau maskot yang sama dari satu shot ke shot berikutnya: wajah, rambut, postur, pakaian, dan suara yang sama. Setiap shot adalah generasi terpisah, jadi tanpa referensi atau lembar karakter, model mengarang ulang karakternya setiap kali.
Oleh tim DreamBench. Diperbarui .
Sekilas tentang konsistensi karakter
Sekilas
- Artinya
- Karakter yang sama tetap dikenali sama di shot 1 dan shot 30, apa pun tempat, cahaya, atau kameranya.
- Mencakup
- Wajah, rambut, tubuh, pakaian, dan properti yang mereka bawa, dan di model yang punya suara, suaranya juga.
- Mengapa ini sulit
- Model video membuat satu shot setiap kali dan tidak mengingat apa pun dari shot sebelumnya.
- Yang menjaganya
- Gambar referensi yang sama, idealnya lembar karakter, dan kata-kata yang sama di setiap shot.
- Tidak sama dengan
- Konsistensi temporal, yang menyangkut keselarasan frame di dalam satu klip.
- Pertama kali gagal pada
- Tampilan samping dan belakang, wajah kecil di wide shot, tangan, dan pakaian yang berubah.
Lembar karakter
Depan
Samping
Kembali
Digambar sekali: wajah, rambut, mantel, dan syal yang sama di setiap tampilan, di latar polos tanpa bayangan dan tanpa orang lain.
Setiap shot
Shot 1: wide, jalan di malam hari
Shot 2: medium, hutan
Shot 3: close-up, di dalam ruangan
Shot 4: wide, pantai di siang hari
Yang menyertai setiap shot
- Lembarnya, sebagai gambar referensi atau gambar diam pembuka
- Penanda yang sama, kata demi kata, di setiap prompt
- Suara yang sama, di model yang menghasilkan suara
Tempat baru, cahaya baru, framing baru: karakternya tetap orang yang sama karena setiap shot diberi lembar yang sama dan kata-kata yang sama, bukan karena model mengingat shot sebelumnya.
Cara AI menjaga karakter tetap sama di seluruh shot
Model video membuat film satu shot setiap kali, dan tidak ada yang berpindah dari shot 4 ke shot 5 kecuali kamu yang memberikannya: model mulai lagi dari noise dan mengarang apa pun yang tidak ditentukan prompt. Tulis “seorang perempuan berambut pirang pendek” dua kali dan kamu akan mendapat dua perempuan yang berbeda.
Jadi konsistensi datang dari apa yang diberikan ke setiap shot. Kata-kata yang sama membantu. Gambar lebih membantu, karena wajah lebih mudah ditunjukkan daripada dijelaskan: model yang menerimanya, mode yang disebut referensi ke video, menjaga wajah, rambut, dan warna yang bisa dilihatnya. Lembar karakter, yaitu karakter dari depan, samping, dan belakang, paling membantu, karena juga menunjukkan mereka saat berbalik.
Memulai shot dari gambar karakter, seperti yang dilakukan gambar ke video, juga bisa: frame pertama ditetapkan, dan makin jauh shot bergerak darinya, makin banyak yang dikarang ulang.
Di balik layar: referensi, identity embedding, dan seed
Gambar referensi sampai ke model lewat attention, mekanisme yang sama dengan yang dipakai teks. IP-Adapter menambahkan gambar sebagai prompt lewat lapisan cross-attention-nya sendiri, terpisah dari milik teks, dalam adapter berukuran sekitar 22 juta parameter, tanpa mengubah model itu sendiri.
Metode identitas melangkah lebih jauh dan mengenkode wajahnya sendiri. InstantID bekerja dari satu foto wajah: jaringan terpisah mengarahkan generasi dengan fitur dan titik-titik penanda wajah itu, sehingga orangnya tetap dikenali sementara gaya dan pose berubah. Wajah yang dienkode itu adalah identity embedding.
Cara tertua adalah mengajari model tentang karakternya. DreamBooth melakukan fine-tune model dengan beberapa gambar sebuah subjek sampai model mengikat satu kata unik padanya, lalu menghasilkan subjek itu di adegan, pose, sudut pandang, dan cahaya baru. LoRA, yang pertama kali diterbitkan untuk model bahasa, membuat fine-tune semacam itu ringan: bobot model tetap dibekukan dan hanya matriks kecil tambahan yang dilatih. Keduanya butuh model yang bobotnya bisa kamu latih.
Gagasan lain adalah menghasilkan gambar-gambarnya bersamaan. StoryDiffusion membagi attention ke sekumpulan gambar, tanpa pelatihan, sehingga subjek tetap selaras di satu seri; model video multi-shot menjaga para pemeran di seluruh potongan yang dibuatnya sendiri dengan cara serupa, tetapi hanya dalam satu generasi.
Kenapa seed tidak membawa karakternya? Seed menetapkan noise awal, jadi seed yang sama dengan prompt, durasi, frame, dan model yang sama mengulang klip yang sama. Shot baru mengubah setidaknya satu di antaranya, noise yang sama dibaca dengan cara baru, dan wajah terakhir tidak tersimpan di mana pun.
Gambar referensi, lembar karakter, seed, atau LoRA: apa yang dijaga masing-masing
| Yang dipertahankan | Yang hilang | |
|---|---|---|
| Deskripsi yang sama di setiap prompt | Garis besarnya: warna rambut, usia, pakaian | Wajahnya. Kata-kata tidak bisa memastikan satu wajah, dan susunan kata yang baru dibaca sebagai orang baru. |
| Seed yang sama | Klip yang sama lagi, dari prompt dan pengaturan yang sama | Semuanya, begitu prompt, durasi, frame, atau modelnya berubah. |
| Satu gambar referensi | Wajah dan warna yang ditunjukkan gambar | Sudut yang tidak ditunjukkannya, dan kadang cahaya serta latar belakangnya ikut terbawa. |
| Lembar karakter | Wajah, rambut, postur, dan pakaian dari beberapa sudut | Apa pun yang tidak ada di lembar: pakaian baru, usia yang lebih tua, wajah yang terlalu kecil untuk terbaca di wide shot. |
| Frame pertama | Gambarnya persis, di detik nol | Apa yang tidak ditunjukkan frame; pergeseran bertambah makin jauh ke dalam shot. |
| Adapter identitas | Wajah dari satu foto, di berbagai gaya dan pose | Pakaian dan tubuh; butuh model yang dibuat untuk menerimanya. |
| Fine-tune (DreamBooth, LoRA) | Subjek yang dipelajari dari beberapa gambar, dalam pose, sudut pandang, dan cahaya baru | Waktu: pelatihan untuk setiap karakter, di model yang bobotnya bisa kamu latih. |
Konsistensi karakter vs konsistensi temporal
Keduanya berujung pada wajah yang berubah, jadi mudah tertukar. Konsistensi temporal ada di dalam satu klip: apakah frame 90 selaras dengan frame 1? Konsistensi karakter ada di antara klip: apakah perempuan di dapur di shot 2 adalah perempuan di kereta di shot 9? Klip yang stabil tetap bisa menampilkan orang yang salah.
Konsisten
Sosok, warna, dan ukuran yang sama, dari frame ke frame; hanya gerakannya yang berubah.
Bergeser
Frame yang ditandai: kilasan warna yang salah (flicker), lalu sosok yang perlahan menjadi orang lain (pergeseran identitas).
| Yang tetap sama | Sepanjang apa | |
|---|---|---|
| Konsistensi karakter | Siapa seseorang: wajah, rambut, postur, pakaian, suara | Setiap shot dan adegan sebuah film |
| Konsistensi temporal | Semua yang ada di frame | Dari satu frame ke frame berikutnya, di dalam satu klip |
| Referensi jadi video | Subjek dari gambar yang kamu berikan | Satu shot; diulang di setiap shot, inilah cara sebagian besar film mendapatkan konsistensi karakter |
| Frame pertama dan terakhir | Kedua ujung sebuah shot | Satu shot: menetapkan pose, bukan identitas sepanjang film |
| Video multi-shot | Para pemeran di seluruh potongan yang dibuat model sendiri | Satu generasi; generasi berikutnya mulai dari awal lagi |
| Konsistensi gaya | Tampilannya: medium, palet, grain | Seluruh film, siapa pun yang ada di shot |
Frame pertama dan terakhir bisa membawa frame terakhir satu shot menjadi frame pertama shot berikutnya: sambungannya halus, tetapi shot 12 tetap tidak mengenal shot 3.
Referensi karakter di Veo, Kling, dan Seedance
Setiap pembuat model punya caranya sendiri. Panduan Vertex AI dari Google menerima hingga tiga gambar satu orang, karakter, atau produk untuk Veo 3.1, dan menyebut Veo mempertahankan penampilan subjek di dalam video; di model standar, klip yang dibuat dengan gambar subjek berdurasi 8 detik.
Kling membangun karakter sebagai element. Panduan Element Library-nya meminta dua sampai empat gambar per element, satu gambar utama dan hingga tiga dari sudut lain, menyarankan gambar utama yang menghadap depan, dan menyebut Kling 3.0 mengikat hingga tiga element ke sebuah frame awal.
Seedance menerima banyak referensi sekaligus, dengan satu aturan yang penting di sini: tutorial seri Seedance 2.0 dari BytePlus menyebut model-model itu tidak menerima gambar atau video referensi yang secara langsung berisi wajah manusia sungguhan, dan menawarkan karakter digitalnya sendiri serta aset orang sungguhan yang berizin sebagai gantinya.
Seperti apa lembar karakter yang bagus
Model menyalin apa yang ditunjukkan referensi, diinginkan atau tidak, jadi lembar yang bagus memang sengaja dibuat polos:
- Wajah dan rambut yang sama di setiap tampilan, depan, samping, dan belakang, dengan warna kulit yang sama di masing-masing.
- Satu karakter per lembar: wajah kedua adalah identitas kedua yang bisa ikut dipinjam.
- Latar polos tanpa bayangan jatuh atau rona warna, yang akan muncul di setiap shot.
- Tanpa teks, label, atau angka, yang bisa ditulis model ke dalam shot.
- Tampilan depan yang jelas sebagai gambar utama, seperti saran Kling, dengan seluruh pakaian terlihat.
- Tempat di lembarnya sendiri, kosong tanpa karakter.
Kenapa wajah karakter berubah di antara shot
| Kenapa itu terjadi | Yang bisa dicoba | |
|---|---|---|
| Pakaian berubah dari adegan ke adegan | Pakaiannya disebut di kata-kata satu shot tapi tidak di shot berikutnya, atau tidak ada di referensi | Tunjukkan seluruh pakaian di lembar, dan sebut dengan kata-kata yang sama di setiap shot. |
| Wajahnya salah dari samping atau belakang | Referensinya hanya menunjukkan bagian depan | Pakai lembar dengan tampilan samping dan belakang, atau jaga kamera tetap di depan karakter. |
| Wajah hilang di wide shot | Wajah setinggi beberapa piksel hanya membawa sedikit dari referensinya | Jaga identitasnya lewat hal yang tetap terbaca meski kecil: rambut, warna, syal, topi. |
| Tangan, kacamata, atau perhiasan berubah | Detail kecil dihasilkan ulang di setiap shot, dan kiri serta kanan mudah tertukar | Sebut detailnya dan di sisi mana letaknya, dan kurangi jumlahnya. |
| Karakter terlihat lebih tua atau lebih muda | Cahaya, riasan, dan ekspresi menggeser kesan usianya | Sebutkan usianya dengan kata-kata di setiap shot, dan jaga cahayanya tetap mirip dengan cahaya di lembar. |
| Rambut memanjang atau memendek | Panjangnya tidak ditetapkan, jadi bergeser seiring gerakan | Sebutkan panjangnya dengan tepat: “bob sebatas dagu”, bukan “rambut pendek”. |
| Dua karakter melebur jadi satu | Karakter yang mirip berbagi ciri lewat attention yang sama | Buat mereka berbeda sekilas pandang, dan beri masing-masing lembarnya sendiri. |
Kenapa karakterku berubah di tengah shot? Itu pergeseran di dalam klip, kegagalan konsistensi temporal: shot yang lebih pendek, gerakan yang lebih sedikit, dan potongan sebelum gerakan berbalik yang besar lebih membantu daripada referensi baru.
Cara menjaga karakter yang sama di video AI: daftar periksa
- Buat karakternya sekali, sebagai lembar, sebelum shot apa pun.
- Beri lembar itu ke setiap shot yang menampilkan mereka, atau mulai setiap shot dari gambar yang dibuat dari lembar itu.
- Tulis beberapa detail penentu mereka kata demi kata di setiap prompt.
- Pakai satu model untuk seluruh film jika bisa: setiap model membaca referensi dengan caranya sendiri.
- Bandingkan gambar diam dari shot yang berbeda secara berdampingan: perubahan yang terlewat saat bergerak terlihat jelas di gambar diam.
Orang sungguhan, kemiripan, dan persetujuan
Gambar referensi orang sungguhan adalah kemiripan orang itu. Pakai milikmu sendiri, atau milik orang yang sudah memberimu izin, dan katakan bahwa videonya buatan AI jika bisa disangka rekaman asli. Sebagian model, termasuk Seedance 2.0, langsung menolak wajah sungguhan.
Di DreamBench, gambar yang diunggah diperiksa sebelum kredit apa pun terpakai, dan gambar yang tampak menampilkan orang sungguhan di bawah 18 tahun ditolak: Ketentuan tidak mengizinkan unggahan atau penggambaran orang sungguhan di bawah 18 tahun. Di Morph, video dengan orang sungguhan baru dibuat setelah kamu mencentang bahwa itu kamu sendiri, atau orang yang sudah memberi izin.
Cara DreamBench menjaga karakter tetap sama di setiap shot
Saat kamu mendeskripsikan film, DreamBench menulis naskahnya, lalu menggambar para pemeran sebelum satu shot pun dirender: setiap karakter, tempat, dan properti sekali, sebagai lembar, yang sama di setiap shot. Tambahkan gambar di bawah “Siapa saja yang tampil?”, ditandai sebagai karakter, makhluk, lokasi, atau properti, dan lembar itu digambar dari gambarmu, dengan mengambil subjeknya saja, bukan cahaya atau latar belakangnya; lembar yang sudah kamu buat sebelumnya dipakai apa adanya.
Sebelum lembar digambar, setiap karakter dan properti diberi kunci identitas: wajah, profil, tubuh, dan ukurannya, ditulis untuk seluruh pemeran sekaligus agar tidak ada dua karakter yang berbagi wajah. Satu baris pendek penanda dari kunci itu ditulis kata demi kata ke setiap shot yang menampilkan karakter tersebut, bersama suara karakter di model yang menghasilkan suara dan jumlah orang di layar.
Cara lembar sampai ke shot bergantung pada modelnya. Di Seedance 2.5, Seedance 2.0, Veo 3.1, dan Vidu Q2, lembar dikirim bersama setiap shot sebagai gambar referensi. Di model lain, termasuk Veo 3.1 Fast dan Lite serta Kling 3.0, DreamBench lebih dulu menggambar gambar diam pembuka dari lembar-lembar shot itu, dan shot dimulai dari gambar diam tersebut.
Perubahan yang dibutuhkan cerita, seperti karakter yang basah kuyup karena hujan, digambar sebagai varian di lembarnya sendiri. Jika kamu memilih untuk meninjau, kamu bertemu para pemeran sebelum apa pun direkam dan bisa menggambar ulang lembar mana pun, atau dari gambarmu sendiri. Shot yang masih meleset diulang dengan catatan yang menyebutkan apa yang perlu diperbaiki.
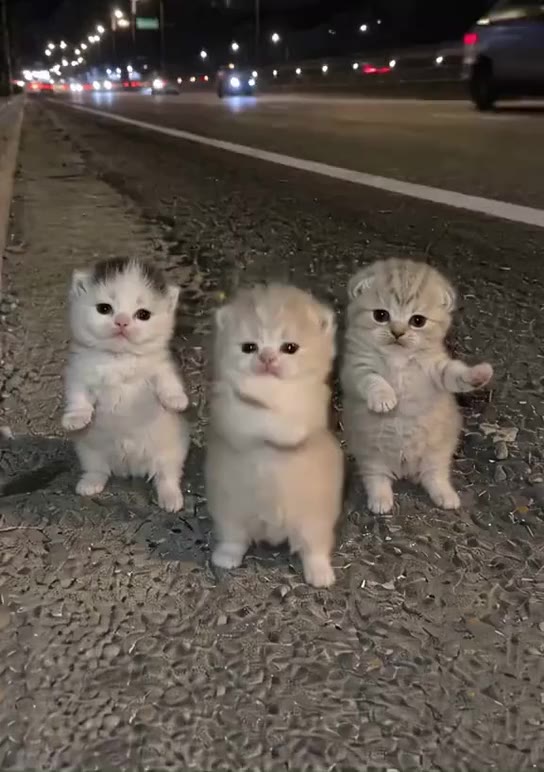 Asli
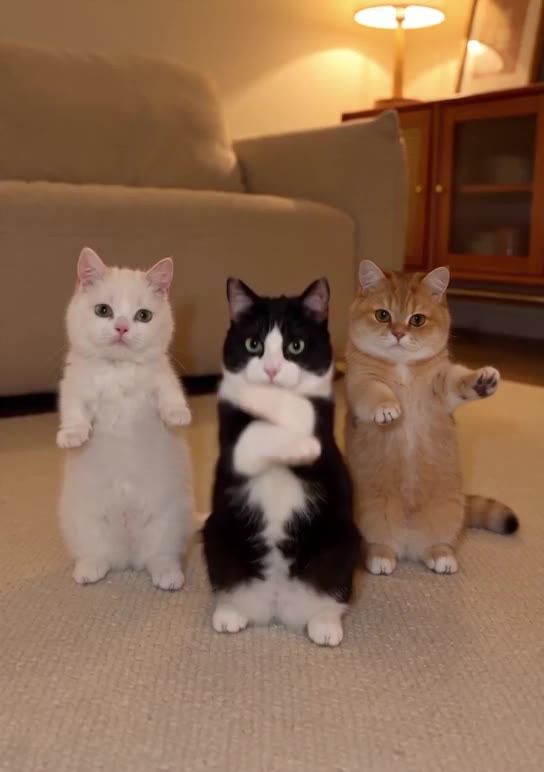 Dengan Morph
Ganti latar belakang menjadi @livingroom, dengan tata letak seperti @floorplan, tapi tukar 3 kucing dengan @yickshuncat, @oreo, dan @mango.
Pertanyaan
Bagaimana cara menjaga karakter yang sama di video AI?
Kamu menjaga karakter yang sama di video AI dengan memberi setiap shot referensi yang sama, idealnya lembar karakter dengan tampilan depan, samping, dan belakang, serta beberapa detail penentu yang sama yang ditulis kata demi kata di setiap prompt. Setiap shot adalah generasi terpisah, jadi apa pun yang tidak kamu ulang akan dikarang ulang.
Kenapa wajah karakterku berubah di antara shot?
Wajah karakter berubah di antara shot karena model video menghasilkan setiap shot dari nol dan tidak mengingat apa pun dari shot sebelumnya. Tanpa gambar referensi dan deskripsi yang sama di setiap shot, model mengarang wajah baru yang sesuai dengan kata-katanya. Tampilan samping, tampilan belakang, dan wajah kecil di wide shot paling mudah bergeser.
Bagaimana cara mendapatkan karakter yang konsisten di Kling?
Di Kling, karakter yang konsisten dibuat sebagai element: panduan Element Library dari Kling meminta dua sampai empat gambar, satu gambar utama dan hingga tiga dari sudut lain, dengan gambar utama menghadap depan untuk konsistensi yang lebih tinggi. Di DreamBench, shot Kling 3.0 dimulai dari gambar diam pembuka yang digambar dari lembar para pemeran.
Apa itu lembar karakter di video AI?
Lembar karakter adalah satu gambar karakter dari beberapa sudut, biasanya depan, samping, dan belakang, dengan wajah, rambut, dan pakaian yang sama di setiap tampilan di atas latar polos. Setiap shot diberi lembar itu sebagai referensi, sehingga model tahu rupa karakter saat mereka berbalik.
Apakah memakai seed yang sama menjaga karakter tetap konsisten?
Tidak. Seed yang sama hanya mengulang klip dengan prompt, durasi, frame, dan model yang sama. Shot baru mengubah setidaknya satu di antaranya, jadi wajahnya juga berubah. Gambar referensi dan kata-kata yang diulang menjaga karakter; seed tidak.
Apa perbedaan konsistensi karakter dan konsistensi temporal?
Konsistensi temporal ada di dalam satu klip: apakah setiap frame selaras dengan frame sebelumnya. Konsistensi karakter ada di antara klip: apakah orang di shot 2 adalah orang yang sama di shot 9. Sebuah klip bisa stabil tetapi tetap menampilkan orang yang salah.
Berapa banyak gambar referensi yang kubutuhkan untuk karakter yang konsisten?
Satu gambar jelas yang menghadap depan adalah minimum, dan beberapa tampilan dari karakter yang sama biasanya lebih terjaga, karena model jadi tahu profil dan bagian belakangnya. Element di Kling menerima dua sampai empat gambar, dan Veo 3.1 dari Google menerima hingga tiga gambar satu subjek.
Bisakah aku memakai fotoku sendiri sebagai karakter video AI?
Bisa, jika modelnya menerima wajah sungguhan: fotomu sendiri adalah kemiripanmu sendiri, dan gambar yang jelas, menghadap depan, dengan pencahayaan rata paling cocok. Sebagian model menolak wajah sungguhan, termasuk Seedance 2.0. Di DreamBench, gambar yang tampak menampilkan orang sungguhan di bawah 18 tahun ditolak.
Kenapa Seedance menolak foto referensiku?
Seedance menolak foto referensi saat mendeteksi wajah manusia sungguhan di dalamnya: BytePlus menyebut model seri Seedance 2.0 tidak menerima gambar atau video referensi yang secara langsung berisi wajah manusia sungguhan, dan menawarkan karakter digital preset serta aset orang sungguhan yang berizin sebagai gantinya.
Kenapa pakaian karakterku berubah di antara adegan?
Pakaian berubah di antara adegan saat pakaiannya tidak ada di referensi atau di prompt, jadi model mengisi kekosongan itu dengan apa pun yang cocok dengan adegannya. Tunjukkan seluruh pakaian di lembar, sebut dengan cara yang sama di setiap shot, dan beri pakaian baru lembarnya sendiri.
Bisakah AI menjaga dua karakter tetap konsisten di adegan yang sama?
Bisa, dengan referensi untuk masing-masing: beri setiap karakter lembarnya sendiri dan sebut masing-masing namanya di prompt, agar model tahu gambar mana yang merupakan orang mana. Karakter yang mirip bisa melebur, jadi buat mereka berbeda sekilas pandang.
Apakah DreamBench menjaga karakter tetap konsisten di sepanjang film?
Ya. DreamBench menggambar setiap karakter, tempat, dan properti sekali sebagai lembar sebelum shot apa pun dirender, menulis penanda setiap karakter kata demi kata ke setiap shot, dan memberi setiap shot lembarnya sebagai referensi atau sebagai gambar diam pembuka, tergantung modelnya.
Terkait
Alat DreamBench
Halaman model
- Seedance 2.5Ceritakan kisah pendek dalam satu klip hingga 30 detik, dipotong menjadi shot-shot yang terhubung, dengan suara yang dibuat bersama gambarnya.
- Veo 3.1Bentuk adegan realistis layar lebar atau vertikal dengan dialog dan suara, di Veo 3.1, Fast, atau Lite.
- Kling 3.0Jadikan gerakan sebagai fokus, dari olahraga dan tari hingga kendaraan, dengan dialog lip-sync dalam 5 bahasa.
Ketentuan
- Konsistensi temporalSeberapa baik video AI menjaga segala sesuatu tetap sama dari frame ke frame, tanpa kedipan atau pergeseran.
- Gambar ke videoVideo AI yang dimulai dari gambar diam, gerakannya dihasilkan dari prompt.
- Referensi jadi videoVideo AI yang menjaga karakter, produk, atau tempat dari gambarmu tetap dikenali dalam shot baru.
- Frame pertama dan terakhirVideo AI yang dibuka dengan satu gambar dan diakhiri gambar lain, dengan gerakan di antaranya dihasilkan oleh model.
- Video multi-shotVideo AI dari beberapa shot yang disambung dengan potongan: direncanakan sebagai daftar shot, dihasilkan shot demi shot, disambung menjadi satu film.
- Audio nativeSuara yang dibuat model video bersama gambarnya: dialog, efek, dan ambience dalam satu timeline.
Sumber
- Membuat video Veo dari gambar referensiGoogle Cloud, dibaca pada
- Panduan pengguna Kling Element LibraryKling AI, dibaca pada
- Tutorial seri Dreamina Seedance 2.0: membuat video potretBytePlus, dibaca pada
- IP-Adapter: Text Compatible Image Prompt Adapter for Text-to-Image Diffusion ModelsarXiv, dibaca pada
- InstantID: Zero-shot Identity-Preserving Generation in SecondsarXiv, dibaca pada
- DreamBooth: Fine Tuning Text-to-Image Diffusion Models for Subject-Driven GenerationarXiv, dibaca pada
- LoRA: Low-Rank Adaptation of Large Language ModelsarXiv, dibaca pada
- StoryDiffusion: Consistent Self-Attention for Long-Range Image and Video GenerationarXiv, dibaca pada
DreamBench adalah platform independen dan tidak berafiliasi dengan atau didukung oleh perusahaan yang disebutkan di halaman ini.