AI 视频生成
什么是参考生视频?
参考生视频(R2V)是一种 AI 视频生成方式,根据提示词和一张或多张角色、产品或地点的参考图生成全新的镜头。与图生视频不同,没有哪张图片会成为一帧:模型让每张参考图展示的内容保持可辨认,同时按提示词的描述决定构图、姿势和动作。
作者:DreamBench 团队。更新于 。
参考生视频概览
概览
- 输入
- 一段提示词和一张或多张图片:一个人、一只动物、一件产品、一个地点。
- 输出
- 一个新镜头,通常 4 到 15 秒,参考的主体会出现在其中。
- 由你决定的部分
- 镜头里有谁、有什么,以及他们的样子。
- 由模型决定的部分
- 构图、姿势、动作和光线,由提示词决定。
- 最适合
- 同一个角色、产品或地点贯穿多个镜头。
- 不擅长
- 几个长得相似的人、产品上的小字,以及被整张照搬的参考图。
参考生视频的原理
参考生视频的原理是让模型在生成时读取你的图片,但不把任何一张放进片段。每张图片说明某样东西长什么样,提示词说明发生什么。随后模型像文生视频一样从噪声中生成每一帧,同时保持它看到的面孔、形状和颜色。
参考图,每张都有名字
@mia角色
她的脸、发型和外套,在每一格中都一样。
@lamp道具
它的形状和颜色,正面和四分之三侧面。
@attic地点
房间本身,空无一人,这样里面的东西就不会被误抄进去。
提示词按名字引用它们
@mia 在黄昏时爬进 @attic,在一块布下找到 @lamp 并把它打开;镜头缓缓推近,她的脸被灯光照亮。
模型生成的新镜头
远景:三者同框
特写:同一张脸,换一个角度
参考图不会直接成为画面中的某一帧。模型保留的是每张图片中的人和物,而他们站在哪里、如何运动、摄影机如何拍摄,都由提示词决定。
这就是它和图生视频的区别:图生视频中,你的图片就是首帧,镜头正好从那里开始。用参考图时,开头由模型决定,所以特写、全景和反打镜头都可以展示同一个人。这是在一部影片的各个镜头中获得一致的角色最常用的方法。
深入原理:参考图放在哪里
开源模型 VACE 把这项任务命名为 R2V,并记录了一种设计:每张参考图用与视频相同的编码器压缩,放在片段的帧之前,并标记为要保留的帧。模型在它们旁边生成片段,解码后再把参考帧剪掉。
由于参考图和帧位于同一个序列中,让第 10 帧与第 11 帧保持一致的注意力机制,也会让它们都与你的图片保持一致。这种方法中没有任何环节会复制图片的姿势或背景:模型是从训练数据对中学会该保留哪些部分的。
Phantom 论文点明了这项任务所依赖的平衡:文字和图片共同引导生成。图片权重过大时,它们的内容就会渗进来,比如照片里的姿势、背景或光线;有多个主体时,模型还可能把它们搞混。
参考生视频提示词怎么写
- 给每张参考图命名,并在它出场的地方引用它:“@mia 从架子上拿起 @lamp”能告诉模型哪张图片扮演哪个角色。
- 描述动作、运镜和光线,而不是主体的长相:图片已经提供了这些,再描述一遍可能会和图片打架。
- 每张图片只做一件事。一张女人拿着台灯的照片,是一张图里有两个主体;把它裁开,否则模型可能会让两者一直绑在一起。
- 即使有地点参考图,也要写明镜头发生在哪里,这样模型就知道它是场景,而不是要贴上去的背景板。
图生视频、首尾帧还是参考生视频?
三者都使用图片,但用法各不相同。关键在于:你的图片应该是片段中的一帧,还是对片段中某样东西的描述。
| 你的图片起什么作用 | 完全由你决定的部分 | 适用于 | |
|---|---|---|---|
| 图生视频 | 成为首帧 | 开场画面,逐像素一致 | 让照片、产品图或设计好的画面动起来 |
| 首尾帧 | 成为首帧和尾帧 | 镜头的两端 | 转场、揭晓、前后对比 |
| 参考生视频 | 描述镜头中包含的主体或地点 | 它们的样子,而不是出现在哪里、如何出现 | 同一个角色、产品或地点出现在多个镜头中 |
| 文生视频 | 没有图片:只有文字 | 只有文字所描述的内容 | 创意、氛围和空镜素材 |
该用哪一种?如果片段必须从你已有的某个画面开始,就用图生视频。如果需要同一张面孔或同一件产品出现在每个都从新位置开始的镜头里,就用参考图:镜头可以从任何地方开始。
每种参考图固定什么
一张参考图有多大用处,取决于它清楚地展示了什么。DreamBench 会让你把每张图片标记为四种类型之一,因为每一种告诉模型的信息都不同:
| 它保留什么 | 仍由模型决定的部分 | 效果好的图片 | |
|---|---|---|---|
| 角色 | 面孔、发型、体型和衣服 | 姿势、表情、构图和光线 | 只有一个人,清晰、光线均匀,面孔在画面中占比大,背景简洁 |
| 生物 | 身体结构、花纹和颜色 | 它如何移动,以及我们从哪个角度看它 | 完整的动物或生物,侧面,前面没有遮挡 |
| 地点 | 布局、标志性景物和材质 | 摄像机放在哪里,以及谁在场 | 空无一人的地点,范围足够展示关键内容,平视角度 |
| 道具 | 形状、颜色、标签或 Logo | 它在哪里、谁拿着它、以什么角度 | 只有物体本身,正面,标签清晰可读 |
产品算作道具。Logo 也是,不过模型最难保留的细节就是它的字母。
参考图在一次真实 DreamBench 编辑中的作用
参考图既能引导新镜头,也能引导编辑。在这次 Morph 编辑中,文字按名称引用了三只猫的角色设定图、一间客厅及其平面图,片段保留了原来的舞蹈,而猫和房间都换了。
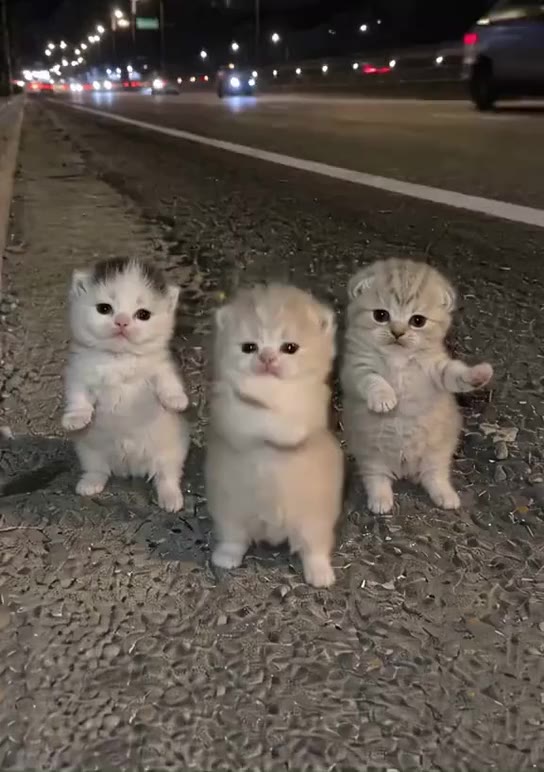 原版
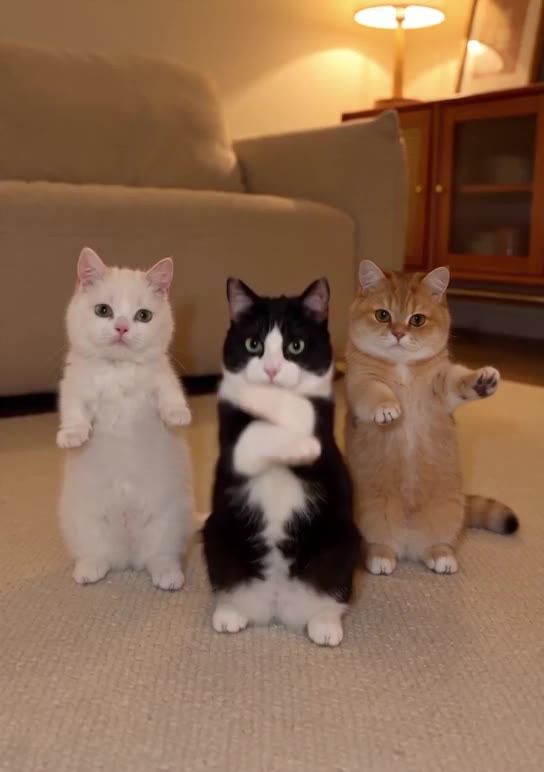 Morph 版
把背景换成 @livingroom,布局与 @floorplan 一致,再把 3 只猫换成 @yickshuncat、@oreo 和 @mango。
这是带参考图的视频生视频,而不是参考生视频,因为动作来自一段真实的片段。参考图在两者中的作用相同:说明出现的是谁、是什么,仅此而已。
Ingredients、Elements、主体参考:同一种思路的不同叫法
每家模型厂商都用自己的方式命名这项功能,也各自设定了图片数量上限。以下是我们查阅时它们官方页面上的说法:
| 厂商的叫法 | 需要提供 | |
|---|---|---|
| Veo 3.1(Google) | Ingredients to video(素材生视频) | 最多 3 张角色、物体或场景的参考图 |
| Kling(Video 3.0 Omni 和 O1) | Elements(主体) | 一个主体包含同一对象的 2 到 4 张图片;单次生成最多 7 张图片或主体,同时提供视频时最多 4 个 |
| Vidu Q2 | 参考生视频 | 1 到 7 张图片(Vidu 2.0 为 1 到 3 张) |
| Seedance 2.0 | 多模态参考 | 最多 9 张图片、3 段视频和 3 段音频 |
| MiniMax S2V-01 | 主体参考 | 一张人脸照片 |
大家用参考生视频做什么
- 每个场景都出现同样角色的短片和系列片。
- 产品广告:一张产品照片,生成很多产品使用中的镜头,标签保持不变。
- 每条帖子里都必须保持同样样貌的吉祥物和品牌角色。
- 把宠物、玩具或手绘角色放进新场景。
- 让同一个地点(一家店、一套公寓)贯穿在那里发生的所有镜头。
- 会动的分镜,演员一出场就是选定的样子。
参考生视频在哪里会出问题
- 照搬:参考图的姿势、背景或光线被整个带进来,每个镜头看起来都像那张照片。简洁的背景和均匀的光线会有帮助。
- 主体混淆:体型和肤色、发色相近的两个人可能会互换面孔或衣服。让他们有明显区别,并在各自出场的地方按名称引用。
- 细节:标签上的小字、Logo 的字母和带图案的布料,比形状和颜色更难保留。
- 看不到的侧面:一张正面人脸参考图,把后脑勺留给模型去猜。包含多个视角的设定图能给它更多可以保留的信息。
- 图片太多:每个模型在一个片段上只能接收有限数量的图片,超出的部分会被舍弃。
- 随时间漂移:较长或画面繁复的镜头仍可能丢失某个细节,这是时序一致性出了问题。
为什么我的角色不像参考图?通常是图片一次展示的东西太多:面孔太小、光线太硬、有其他人或背景太乱。使用一张只有主体本身的清晰图片,提示词里不要再描述其长相,并让镜头保持简短。
真人参考图:同意与规则
一张真人参考图,可以把这个人放进他从未到过的场景。请使用你自己的面孔,或已同意这种用途的人的面孔;如果视频可能被当成真实影像,请加以标注。
- DreamBench 的使用条款要求在用 AI 呈现真人的肖像或声音之前获得知情许可,并禁止未经授权呈现真人、冒充他人和虚假代言。
- 每张上传的图片都会在使用任何积分之前接受检查:裸露、血腥和自残内容会被拒绝,看起来未满 18 岁的写实人物也会被拒绝。
- Seedance 不接受真人面孔。含有真人面孔的参考图会被拒绝,DreamBench 会告诉你这一点,并为这些场景推荐另一个视频模型。
- 模型厂商也有自己的规则:例如 MiniMax 的主体参考只接受一张人脸照片。
DreamBench 上哪些视频模型支持参考图
DreamBench 上的每个视频模型都会使用你的参考图。其中四个模型会让图片随每个片段一起发送给视频模型。其余模型则先由图片模型根据参考图绘制片段的开场静帧,再由视频模型让这张静帧动起来:
| 单个片段的图片数 | 它们如何进入片段 | |
|---|---|---|
| Seedance 2.5 | 最多 30 张 | 随片段本身发送;其中一个位置可以放片段的开场静帧 |
| Seedance 2.0 | 最多 9 张 | 随片段本身发送;其中一个位置可以放片段的开场静帧 |
| Veo 3.1 | 最多 3 张 | 随片段本身发送 |
| Vidu Q2 | 最多 7 张 | 随片段本身发送:Vidu Q2 只根据参考图渲染 |
| Kling 3.0、Wan、LTX-2.3、HappyHorse 1.1、Grok Imagine 1.5、MiniMax H3 | 最多 6 张,通过开场静帧 | 图片模型根据它们绘制开场静帧;之后片段按图生视频生成 |
当一个片段的模型能接收的图片少于场景里的数量时,会优先保留你自己上传的图片。Seedance 2.5 接收得最多,Veo 3.1 最少,所以人物和道具很多的场景更适合放在 Seedance 上,前提是其中没有真人面孔。
DreamBench 如何使用参考图
在创作面板中,你描述影片,并添加最多 8 张参考图。每张图都有一个名称和一个标签:角色、生物、地点或道具。名称会成为它的 handle,这样简报就可以引用它,比如“@mia 打开盒子,取出 @lamp”;在简报里输入 @ 就会列出所有 handle。
接着,DreamBench 会为影片需要的每个角色、地点和道具绘制一张设定图。根据你的图片制作的设定图,画的就是图片中那个确切的主体;名称表明本身就是设定图的图片,则按原样使用。
- 角色设定图:面部特写、全身正面和背面,以及一个四分之三侧面,每一格都是同一张面孔,灰色纯色背景。
- 道具设定图:物体的正面和四分之三侧面。
- 地点设定图:只有地点本身,没有人物和道具,这样它们都不会被照搬过去。
每个片段都会带上其中内容的设定图,DreamBench 会编写引用这些设定图的镜头提示词。在“编辑场景”中,每个场景都会显示它的参考图:可以移除一张、添加影片的另一张设定图或上传你自己的图片,数量最多为该场景的模型能接收的上限。
你也可以从工具开始。商品图转视频工具生成片段后,点击“延续成故事”会打开创作面板,你的照片会作为 @product 参考图,简报中也会引用它。
前 4 张参考图包含在视频的基础价格中,超出的每一张会加上它所需设定图的价格。从之前的影片中选用的设定图按原样使用,不另外收费。生成之前,创作面板会以积分显示总价。
常见问题
R2V 是什么意思?
R2V 是 reference to video 的缩写,即参考生视频:根据提示词和角色、物体或地点的参考图生成新的视频镜头。T2V(文生视频)和 I2V(图生视频)是另外两种常见模式的名称。
图生视频和参考生视频有什么区别?
在图生视频中,你的图片成为首帧,所以片段正好从它开始。在参考生视频中,没有哪张图片是一帧:模型保留主体的样貌,并选择新的构图、姿势和动作,所以同一个人可以出现在全景和特写中。
Veo 的 Ingredients to video 是什么?
Ingredients to video(素材生视频)是 Google 对 Veo 3.1 参考生视频功能的叫法。Google 在 2025 年 10 月的发布公告中表示,你可以提供最多 3 张角色、物体或场景的参考图来引导生成,例如让角色在多个镜头中保持一致。
Kling AI 的 Elements(主体)是什么?
Elements(主体)是 Kling 保存的参考:一个主体包含同一对象的 2 到 4 张图片,一张主图加最多 3 张补充图,提示词用 @ 引用它。Kling 的指南允许在一次 Video 3.0 Omni 或 O1 生成中使用最多 7 张图片或主体,同时提供视频时最多 4 个。
可以用多少张参考图?
取决于模型:根据各厂商页面,Veo 3.1 最多 3 张,Vidu Q2 最多 7 张,Seedance 2.0 最多 9 张。在 DreamBench 上,一部影片最多可用 8 张你自己的图片,每个片段带上其模型能接收的数量,Seedance 2.5 最多 30 张。
可以用我自己的照片作参考图吗?
可以,前提是模型接受真人面孔。Seedance 不接受:含有真人面孔的参考图会被它拒绝,所以在 DreamBench 上这类场景需要换一个视频模型。只使用你获得许可的面孔;未满 18 岁者的照片会被拒绝。
为什么我的视频照搬了参考照片的背景?
模型会考虑整张图片,所以强烈的背景、姿势或光线可能会被当成主体的一部分带进来。使用一张只有主体本身、背景简洁的图片,在提示词里描述场景,或者为它单独提供一张地点参考图。
能让同一个角色出现在多个镜头中吗?
能。这正是参考图最常见的用途:每个镜头都使用同样的图片,所以面孔和衣服在切镜后也能保持不变。在 DreamBench 上,每个角色都有一张包含多个视角的设定图,这个角色出现的每个片段都会带上它。
什么样的参考图效果好?
只有一个主体,清晰、光线均匀、在画面中占比大、背景简洁,没有任何遮挡。如果是人,清晰的面孔再加一张全身图会有帮助;如果是产品,正面视角且标签清晰可读。
参考图可以是产品或 Logo 吗?
可以。把它标记为道具,并在提示词中它出现的地方引用它。形状和颜色保留得最稳定;标签上的小字和 Logo 的字母最容易出错,所以使用片段之前请先检查。
可以用参考图来设定地点吗?
可以。一张地点图片标记为地点后,就能在多个镜头中保持布局和材质。使用没有人和产品的空地点,这样站在里面的东西都不会被照搬进场景。
使用参考图会更贵吗?
在 DreamBench 上,前 4 张参考图包含在视频的基础价格中,超出的每一张会加上它所需设定图的价格;从之前的影片中选用的设定图不另外收费。生成第一个视频之前,你需要创建免费账号并选择套餐;生成之前,创作面板会显示总价。
相关内容
在 DreamBench 上
DreamBench 工具
模型页面
术语
来源
- VACE: All-in-One Video Creation and EditingarXiv,查阅于
- Phantom: Subject-consistent video generation via cross-modal alignmentarXiv,查阅于
- 在 Gemini API 中推出 Veo 3.1 和新的创意功能Google,查阅于
- Kling 主体库使用指南Kling AI,查阅于
- Vidu API 文档:参考生视频Vidu,查阅于
- Seedance 2.0: Advancing Video Generation for World ComplexityarXiv,查阅于
- MiniMax API 参考:主体参考生视频MiniMax,查阅于
DreamBench 是一个独立平台,与本页提及的公司没有关联,也未获得它们的认可。