AI 视频生成
AI 视频中的角色一致性是什么?
角色一致性是指 AI 视频在一个镜头到下一个镜头之间,能否让同一个角色看起来仍是同一个人、同一只生物或同一个吉祥物:同样的面孔、发型、体型、衣服和声音。每个镜头都是一次单独的生成,所以如果没有参考图或角色设定图,模型每次都会重新创造这个角色。
作者:DreamBench 团队。更新于 。
角色一致性概览
概览
- 含义
- 同一个角色在第 1 个镜头和第 30 个镜头里都能被认出来,无论地点、光线或镜头如何变化。
- 涵盖
- 面孔、发型、身体、衣服和随身道具;在带声音的模型上,还包括声音。
- 难在哪里
- 视频模型一次只生成一个镜头,不会记得上一个镜头的任何内容。
- 靠什么维持
- 同样的参考图(理想情况下是角色设定图),以及每个镜头里同样的文字。
- 不同于
- 时序一致性,它关心的是一个片段内各帧之间是否一致。
- 最先出问题的地方
- 侧面和背面视角、全景中的小面孔、手,以及会变的衣服。
角色设定图
正面
侧面
返回
只画一次:每个视角中都是同样的脸、发型、外套和围巾,背景纯色,没有阴影,也没有其他人。
每个镜头
镜头 1:远景,夜晚的街道
镜头 2:中景,一片森林
镜头 3:特写,室内
镜头 4:远景,白天的海滩
每个镜头都要附带的内容
- 设定图,作为参考图或开场画面
- 每条提示词中都使用一字不差的同样标识
- 同样的嗓音,在能生成声音的模型上
新的地点、新的光线、新的取景:角色依然是同一个人,因为每个镜头都收到了同样的设定图和同样的文字,而不是因为模型记得上一个镜头。
AI 如何让角色在多个镜头中保持一致
视频模型一次生成影片的一个镜头,除非你主动传递,否则第 4 个镜头的任何信息都不会传到第 5 个镜头:模型会重新从噪声开始,提示词没写到的地方全凭它创造。把“一个金色短发的女人”写两遍,你会得到两个不同的女人。
所以一致性来自每个镜头被提供了什么。同样的文字有帮助。图片帮助更大,因为面孔展示起来比描述起来容易:支持图片的模型(这种模式叫参考生视频)会保留它们能看到的面孔、发型和颜色。角色设定图(从正面、侧面和背面展示角色)帮助最大,因为它还展示了角色转过身的样子。
像图生视频那样从一张角色图片开始一个镜头也可行:首帧是固定的,但镜头离它越远,重新创造的内容就越多。
深入原理:参考图、身份嵌入和种子
参考图通过注意力机制进入模型,与文字使用的机制相同。IP-Adapter 通过自己的交叉注意力层把图片作为提示加入,与文字的交叉注意力层分开,整个适配器约 2200 万(22M)个参数,模型本身保持不变。
身份方法更进一步,直接对面孔本身编码。InstantID 只需一张人脸照片:一个独立的网络用这张面孔的特征和关键点引导生成,让人物在风格和姿势变化时仍可辨认。这种编码后的面孔就是身份嵌入。
最古老的方法是教会模型认识这个角色。DreamBooth 用一个主体的几张图片微调模型,直到它把一个独特的词与这个主体绑定,然后在新的场景、姿势、视角和光线中生成这个主体。LoRA 最初是为语言模型发表的,它让这种微调变得轻量:模型自身的权重保持冻结,只训练少量附加矩阵。两者都需要一个你能训练其权重的模型。
另一种思路是把图片放在一起生成。StoryDiffusion 在一批图片之间共享注意力,无需训练,让主体在一组图片中保持一致;多镜头视频模型也以类似的方式,在它们自己切出的镜头之间保持角色一致,但仅限于一次生成之内。
为什么种子保不住角色?种子固定的是初始噪声,所以同样的种子配上同样的提示词、时长、画幅和模型,会重复生成同样的片段。新镜头至少会改变其中一项,同样的噪声就会被以新的方式解读,而上一张面孔并没有被保存在任何地方。
参考图、角色设定图、种子还是 LoRA:各自能保留什么
| 保留的内容 | 它会丢失什么 | |
|---|---|---|
| 每段提示词里都用同样的描述 | 大致特征:发色、年龄、服装 | 面孔。文字无法锁定一张面孔,换一种措辞就会被当成另一个人。 |
| 同样的种子 | 用同样的提示词和设置,再次生成同样的片段 | 一切,只要提示词、时长、画幅或模型有变化。 |
| 一张参考图 | 图片中展示的面孔和颜色 | 图片没有展示的角度,有时它的光线和背景也会被带进来。 |
| 一张角色设定图 | 多个角度的面孔、发型、体型和服装 | 设定图上没有的一切:新服装、更大的年龄、在全景中小到看不清的面孔。 |
| 一张首帧 | 第 0 秒的画面,完全一致 | 画面中没有展示的内容;镜头越往后,漂移越大。 |
| 身份适配器 | 来自一张照片的面孔,跨越不同风格和姿势 | 衣服和身体;而且需要专门为接收它而构建的模型。 |
| 微调(DreamBooth、LoRA) | 从多张图片学到的主体,呈现在新的姿势、视角和光线中 | 时间:每个角色都要训练,而且模型的权重必须可以训练。 |
角色一致性与时序一致性
两者的结果都是面孔发生变化,所以很容易混淆。时序一致性针对的是一个片段内部:第 90 帧和第 1 帧是否一致?角色一致性针对的是片段之间:第 2 个镜头里厨房中的女人,是不是第 9 个镜头里火车上的那个女人?一个稳定的片段,仍可能出现的是错误的人。
一致
同样的人物、颜色和大小,一帧接一帧;只有动作在变化。
漂移
标记出的帧:先是一次颜色错误的闪现(闪烁),接着一个人物慢慢变成了另一个人(身份漂移)。
| 保持不变的是什么 | 范围 | |
|---|---|---|
| 角色一致性 | 一个人是谁:面孔、发型、体型、衣服、声音 | 一部影片的每个镜头和每个场景 |
| 时序一致性 | 画面中的一切 | 一个片段内,一帧到下一帧 |
| 参考生视频 | 来自你提供的图片的主体 | 一个镜头;在每个镜头中重复使用,就是大多数影片获得角色一致性的方式 |
| 首尾帧 | 镜头的两端 | 一个镜头:它锁定的是姿势,而不是整部影片中的身份 |
| 多镜头视频 | 模型自己切出的镜头之间的角色 | 一次生成;下一次生成会重新开始 |
| 风格一致性 | 整体观感:媒介、色调、颗粒感 | 整部影片,无论镜头里是谁 |
首尾帧可以把一个镜头的最后一帧带到下一个镜头的第一帧:衔接很顺,但第 12 个镜头仍然不知道第 3 个镜头是什么样。
Veo、Kling 和 Seedance 的角色参考
每家模型厂商都有自己的做法。Google 的 Vertex AI 指南中,Veo 3.1 可接收最多三张同一个人、角色或产品的图片,并称 Veo 会在视频中保留主体的外观;在标准模型上,使用主体图片生成的片段时长为 8 秒。
Kling 把角色构建为主体。它的主体库指南要求每个主体 2 到 4 张图片,一张主图加最多三张其他角度的图片,建议主图为正面,并称 Kling 3.0 可以把最多三个主体绑定到一张首帧上。
Seedance 可以同时接收很多参考,但有一条规则在这里很重要:BytePlus 的 Seedance 2.0 系列教程指出,这些模型不接受直接包含真人面孔的参考图或参考视频,并提供它自己的数字人和经过授权的真人素材作为替代。
好的角色设定图是什么样的
参考图上展示的东西,不管你想不想要,模型都会照搬,所以好的设定图会刻意保持简洁:
- 每个视角(正面、侧面和背面)里都是同样的面孔和发型,肤色也一致。
- 一张设定图只放一个角色:多一张面孔,就多一个可以借用的身份。
- 简洁的底色,没有投影或偏色,否则它们会出现在每个镜头里。
- 不要文字、标签或数字,模型可能会把它们写进镜头里。
- 按 Kling 的建议,用一张清晰的正面图作为主图,并露出完整服装。
- 地点单独放在自己的设定图上,不含角色。
角色的脸为什么会在镜头之间变化
| 原因 | 可以尝试 | |
|---|---|---|
| 衣服在不同场景之间发生变化 | 服装只写在一个镜头的文字里而下一个没写,或者参考图上没有 | 在设定图上展示完整服装,并在每个镜头里用同样的文字写出来。 |
| 从侧面或背面看,面孔不对 | 参考图只展示了正面 | 使用带侧面和背面视角的设定图,或者让镜头保持在角色前方。 |
| 全景中面孔走样 | 只有几个像素高的面孔,几乎承载不了参考图的信息 | 用小尺寸下也能看清的特征来维持身份:发型、颜色、一条围巾、一顶帽子。 |
| 手、眼镜或首饰发生变化 | 小细节在每个镜头中都会被重新生成,左右也很容易对调 | 写明这个细节以及它在哪一侧,并减少这类细节的数量。 |
| 角色看起来变老或变年轻了 | 光线、妆容和表情会改变看上去的年龄 | 在每个镜头里用文字写明年龄,并让光线接近设定图的光线。 |
| 头发变长或变短 | 长度没有锁定,所以会随着动作漂移 | 把长度写准确:“齐下巴的波波头”,而不是“短发”。 |
| 两个角色融合成一个 | 相似的角色通过同一套注意力机制共享特征 | 让他们一眼就能区分,并给每个角色单独一张设定图。 |
为什么我的角色在一个镜头中途变了样?这是片段内部的漂移,属于时序一致性问题:缩短镜头、减少运动、在大幅转身之前切镜,比换一张新的参考图更有用。
如何在 AI 视频中保持同一个角色:检查清单
- 在拍任何镜头之前,先把角色做成一张设定图,只做一次。
- 把这张设定图提供给出现这个角色的每个镜头,或者让每个镜头都从根据它制作的图片开始。
- 在每段提示词里逐字写出角色的几个关键特征。
- 尽可能整部影片都用同一个模型:每个模型读取参考图的方式都不同。
- 把不同镜头的静帧并排比较:在运动中注意不到的变化,在静帧里一目了然。
真人、肖像与同意
DreamBench 如何让角色在每个镜头中保持一致
当你描述一部影片时,DreamBench 会先写好剧本,然后在渲染任何镜头之前先画好全体角色:每个角色、地点和道具都只画一次,做成设定图,在每个镜头中保持一致。在“画面里是谁?”下添加一张图片,并标记为角色、生物、地点或道具,设定图就会根据你的图片绘制,只取主体本身,而不带上它的光线或背景;你之前做过的设定图则按原样使用。
在绘制设定图之前,每个角色和道具都会获得一个身份锁定:面孔、侧脸、身体和尺寸,为全体角色一次性写好,让任何两个角色都不会共用一张面孔。从中提取的一小行标识信息,会被逐字写进出现这个角色的每个镜头,在能生成声音的模型上还会加上角色的声音,以及画面中的人数。
设定图如何进入镜头取决于模型。在 Seedance 2.5、Seedance 2.0、Veo 3.1 和 Vidu Q2 上,设定图会作为参考图随每个镜头一起发送。在其他模型上(包括 Veo 3.1 Fast、Lite 和 Kling 3.0),DreamBench 会先根据镜头的设定图绘制一张开场静帧,镜头再从这张静帧开始。
故事需要的变化,比如角色被雨淋湿,会在他们自己的设定图上画成一个变体。如果你选择审阅,就能在拍任何镜头之前先见到全体角色,并可以重新绘制任意一张设定图,或根据你自己的图片重新绘制。仍不理想的镜头,可以附上说明要修正什么的备注重拍。
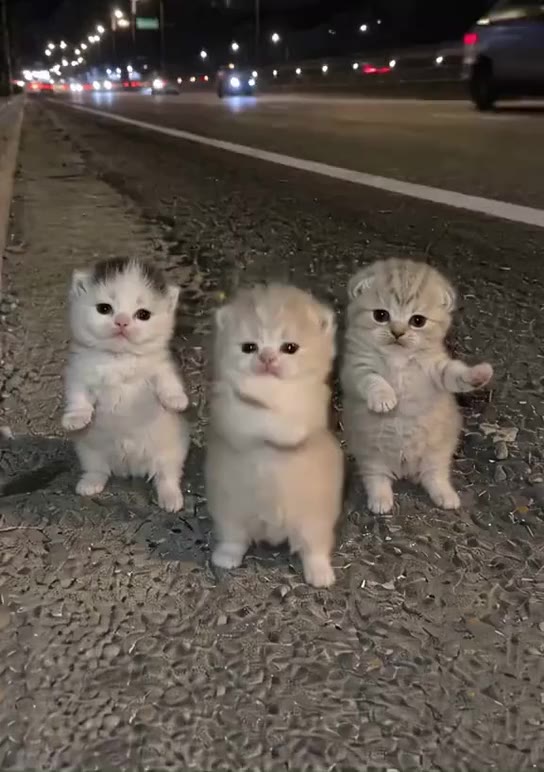 原版
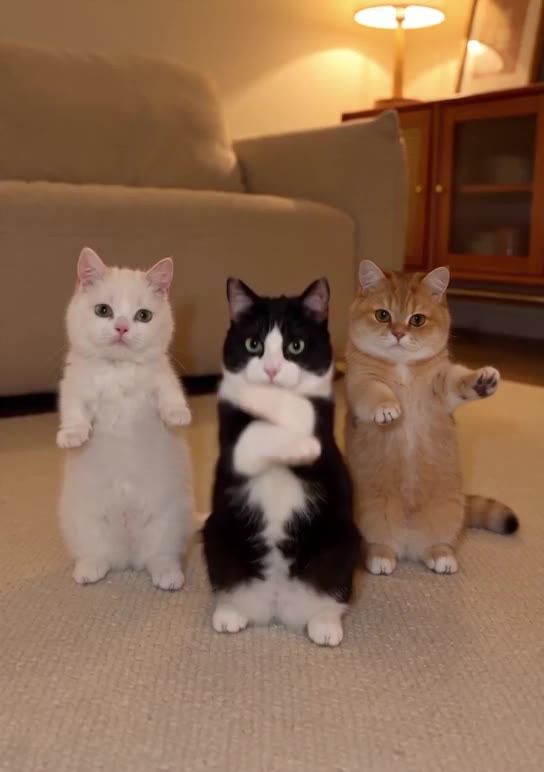 Morph 版
把背景换成 @livingroom,布局与 @floorplan 一致,再把 3 只猫换成 @yickshuncat、@oreo 和 @mango。
常见问题
如何在 AI 视频中保持同一个角色?
在 AI 视频中保持同一个角色的方法是:给每个镜头提供同样的参考图(理想情况下是包含正面、侧面和背面视角的角色设定图),并在每段提示词里逐字写出同样的几个关键特征。每个镜头都是一次单独的生成,所以你没有重复的内容都会被重新创造。
为什么我的角色的脸在镜头之间会变?
角色的脸在镜头之间会变,是因为视频模型每个镜头都从零生成,不会记得上一个镜头的任何内容。如果每个镜头里没有同样的参考图和描述,它就会创造一张符合文字描述的新面孔。侧面、背面以及全景中的小面孔漂移得最厉害。
Kling 怎么保持角色一致?
在 Kling 中,一致的角色是以主体(Elements)的形式制作的:Kling 的主体库指南要求 2 到 4 张图片,一张主图加最多三张其他角度的图片,主图为正面时一致性更高。在 DreamBench 上,Kling 3.0 的镜头从一张根据角色设定图绘制的开场静帧开始。
AI 视频中的角色设定图是什么?
角色设定图是一张从多个角度展示角色的图片,通常包括正面、侧面和背面,每个视角里的面孔、发型和服装都相同,底色简洁。每个镜头都会把它作为参考图,这样模型就知道角色转身时是什么样子。
用同样的种子能保持角色一致吗?
不能。同样的种子只有在提示词、时长、画幅和模型都相同时才会重复生成同一个片段。新镜头至少会改变其中一项,所以面孔也会变。能保持角色一致的是参考图和重复的措辞,而不是种子。
角色一致性和时序一致性有什么区别?
时序一致性针对一个片段内部:每一帧是否与前一帧一致。角色一致性针对片段之间:第 2 个镜头里的人是不是第 9 个镜头里的同一个人。一个片段可以很稳定,却仍然出现错误的人。
保持角色一致需要多少张参考图?
最少需要一张清晰的正面图片;同一个角色的几个视角通常效果更好,因为模型这样就知道侧脸和背面的样子。Kling 的主体需要 2 到 4 张图片,Google 的 Veo 3.1 最多接收三张同一主体的图片。
可以用我自己的照片作为 AI 视频角色吗?
可以,前提是模型接受真人面孔:你自己的照片就是你自己的肖像,清晰、正面、光线均匀的图片最合适。有些模型会拒绝真人面孔,Seedance 2.0 就是其中之一。在 DreamBench 上,看起来是未满 18 岁真人的图片会被拒绝。
为什么 Seedance 拒绝我的参考照片?
当 Seedance 在参考照片中识别出真人面孔时,就会拒绝它:BytePlus 表示,Seedance 2.0 系列模型不接受直接包含真人面孔的参考图或参考视频,并提供预设的数字人和经过授权的真人素材作为替代。
为什么我的角色的衣服在不同场景之间会变?
当参考图或提示词里缺少服装时,衣服就会在场景之间变化,模型会用适合当前场景的任何服装来填补空缺。在设定图上展示完整服装,在每个镜头里用同样的方式写出来,新服装则单独做一张设定图。
AI 能在同一个场景里让两个角色都保持一致吗?
能,只要每个角色都有一张参考图:给每个角色单独一张设定图,并在提示词里分别写出名称,这样模型就知道哪张图片是哪个人。长得相像的角色可能会融合,所以让他们一眼就能区分。
DreamBench 能让角色在整部影片中保持一致吗?
能。DreamBench 在渲染任何镜头之前,就会把每个角色、地点和道具各画一次,做成设定图;把每个角色的标识信息逐字写进每个镜头;并根据模型的不同,把设定图作为参考图或开场静帧提供给每个镜头。
相关内容
在 DreamBench 上
DreamBench 工具
模型页面
术语
来源
- 用参考图生成 Veo 视频Google Cloud,查阅于
- Kling 主体库使用指南Kling AI,查阅于
- Dreamina Seedance 2.0 系列教程:制作人像视频BytePlus,查阅于
- IP-Adapter: Text Compatible Image Prompt Adapter for Text-to-Image Diffusion ModelsarXiv,查阅于
- InstantID: Zero-shot Identity-Preserving Generation in SecondsarXiv,查阅于
- DreamBooth: Fine Tuning Text-to-Image Diffusion Models for Subject-Driven GenerationarXiv,查阅于
- LoRA: Low-Rank Adaptation of Large Language ModelsarXiv,查阅于
- StoryDiffusion: Consistent Self-Attention for Long-Range Image and Video GenerationarXiv,查阅于
DreamBench 是一个独立平台,与本页提及的公司没有关联,也未获得它们的认可。