Geração de vídeo com IA
O que é consistência de personagem no vídeo com IA?
Consistência de personagem é o quanto um vídeo com IA mantém o mesmo personagem com cara da mesma pessoa, criatura ou mascote de um plano para o outro: o mesmo rosto, cabelo, porte físico, roupa e voz. Cada plano é uma geração separada, então, sem referências ou uma ficha de personagem, o modelo reinventa o personagem toda vez.
Pela Equipe DreamBench. Atualizado em .
Consistência de personagem em resumo
Visão geral
- Significa
- O mesmo personagem é reconhecivelmente o mesmo no plano 1 e no plano 30, seja qual for o lugar, a luz ou a câmera.
- Abrange
- Rosto, cabelo, corpo, roupa e os objetos que ele carrega e, nos modelos com som, a voz.
- Por que é difícil
- Um modelo de vídeo cria um plano de cada vez e não se lembra de nada do anterior.
- O que a sustenta
- As mesmas imagens de referência, de preferência uma ficha de personagem, e as mesmas palavras em todos os planos.
- Não é o mesmo que
- Consistência temporal, que trata de quadros que concordam entre si dentro de um clipe.
- Falha primeiro em
- Vistas de lado e de costas, rostos pequenos em planos abertos, mãos e roupas que mudam.
Ficha de personagem
Frente
Lado
Voltar
Desenhada uma vez: o mesmo rosto, cabelo, casaco e cachecol em todas as vistas, sobre um fundo liso, sem sombra e sem mais ninguém.
Todos os planos
Plano 1: aberto, uma rua à noite
Plano 2: médio, uma floresta
Plano 3: close, num interior
Plano 4: aberto, uma praia de dia
O que vai com cada plano
- A ficha, como imagem de referência ou como quadro inicial
- Os mesmos identificadores, palavra por palavra, em todos os prompts
- A mesma voz, nos modelos que fazem som
Lugar novo, luz nova, enquadramento novo: o personagem continua sendo a mesma pessoa porque todo plano recebe a mesma ficha e as mesmas palavras, não porque o modelo se lembra do plano anterior.
Como a IA mantém um personagem igual de um plano para outro
Um modelo de vídeo cria um filme um plano de cada vez, e nada passa do plano 4 para o plano 5 a menos que você passe: o modelo recomeça do ruído e inventa tudo o que o prompt deixa em aberto. Escreva “uma mulher de cabelo loiro curto” duas vezes e você terá duas mulheres diferentes.
Então a consistência vem do que cada plano recebe. As mesmas palavras ajudam. Uma imagem ajuda mais, porque é mais fácil mostrar um rosto do que descrevê-lo: os modelos que aceitam uma, o modo chamado referência para vídeo, mantêm o rosto, o cabelo e as cores que conseguem ver. Uma ficha de personagem, com o personagem de frente, de lado e de costas, ajuda ainda mais, porque também mostra como ele é virado.
Começar um plano a partir de uma imagem do personagem, como faz imagem para vídeo, também funciona: o primeiro quadro fica fixo, e quanto mais o plano se afasta dele, mais coisas são inventadas de novo.
Por dentro: referências, embeddings de identidade e seeds
Uma imagem de referência chega ao modelo pela atenção, o mesmo mecanismo que o texto usa. O IP-Adapter acrescenta uma imagem como prompt por meio de camadas de atenção cruzada próprias, separadas das do texto, num adaptador de cerca de 22 milhões de parâmetros, sem alterar o próprio modelo.
Os métodos de identidade vão além e codificam o próprio rosto. O InstantID trabalha a partir de uma única foto de um rosto: uma rede separada guia a geração com os traços e os pontos de referência desse rosto, para que a pessoa continue reconhecível enquanto o estilo e a pose mudam. Esse rosto codificado é um embedding de identidade.
O caminho mais antigo é ensinar o personagem ao modelo. O DreamBooth faz o ajuste fino de um modelo com algumas imagens de um elemento até associá-lo a uma palavra única, e depois gera esse elemento em cenas, poses, vistas e luzes novas. O LoRA, publicado primeiro para modelos de linguagem, deixa esse ajuste fino leve: os pesos do próprio modelo ficam congelados e só pequenas matrizes acrescentadas são treinadas. Os dois precisam de um modelo cujos pesos você possa treinar.
Outra ideia é gerar as imagens juntas. O StoryDiffusion compartilha a atenção entre um lote de imagens, sem treino, para que um elemento seja coerente ao longo de uma série; os modelos de vídeo com vários planos mantêm um elenco entre os próprios cortes de forma parecida, mas só dentro de uma geração.
Por que a seed não mantém o personagem? Uma seed fixa o ruído inicial, então a mesma seed com o mesmo prompt, a mesma duração, o mesmo formato e o mesmo modelo repete o mesmo clipe. Um plano novo muda pelo menos um desses itens, o mesmo ruído é lido de um jeito novo, e o último rosto não fica guardado em lugar nenhum.
Imagem de referência, ficha de personagem, seed ou LoRA: o que cada um mantém
| O que é mantido | O que perde | |
|---|---|---|
| A mesma descrição em todo prompt | O geral: cor do cabelo, idade, a roupa | O rosto. Palavras não conseguem fixar um, e uma redação nova é lida como uma pessoa nova. |
| A mesma seed | O mesmo clipe de novo, a partir do mesmo prompt e das mesmas configurações | Tudo, assim que o prompt, a duração, o formato ou o modelo mudam. |
| Uma imagem de referência | O rosto e as cores que a imagem mostra | Os ângulos que ela não mostra, e às vezes a luz e o fundo dela vêm junto. |
| Uma ficha de personagem | Rosto, cabelo, porte físico e roupa de vários ângulos | Tudo o que não está na ficha: uma roupa nova, uma idade posterior, um rosto pequeno demais para ser lido num plano aberto. |
| Um primeiro quadro | A imagem exata, no segundo zero | O que o quadro não mostra; o desvio cresce conforme o plano avança. |
| Um adaptador de identidade | Um rosto a partir de uma foto, em vários estilos e poses | Roupa e corpo; ele precisa de um modelo feito para receber um adaptador. |
| Um ajuste fino (DreamBooth, LoRA) | Um elemento aprendido a partir de várias imagens, em poses, vistas e luzes novas | Tempo: treino para cada personagem, num modelo cujos pesos você possa treinar. |
Consistência de personagem x consistência temporal
As duas acabam num rosto que muda, então é fácil confundi-las. A consistência temporal acontece dentro de um clipe: o quadro 90 concorda com o quadro 1? A consistência de personagem acontece entre clipes: a mulher na cozinha no plano 2 é a mesma mulher no trem no plano 9? Um clipe estável ainda pode mostrar a pessoa errada.
Consistente
A mesma figura, cor e tamanho, quadro após quadro; só o movimento muda.
Com desvio
Quadros marcados: um lampejo da cor errada (cintilação) e depois uma figura que aos poucos vira outra pessoa (desvio de identidade).
| O que continua igual | Ao longo de quê | |
|---|---|---|
| Consistência de personagem | Quem a pessoa é: rosto, cabelo, porte físico, roupa, voz | Todos os planos e cenas de um filme |
| Consistência temporal | Tudo o que está no quadro | De um quadro para o seguinte, dentro de um clipe |
| Referência para vídeo | Um elemento das imagens que você fornece | Um plano; repetida em todos os planos, é como a maioria dos filmes consegue consistência de personagem |
| Primeiro e último quadro | As duas pontas de um plano | Um plano: fixa uma pose, não uma identidade ao longo de um filme |
| Vídeo com vários planos | O elenco entre os cortes que o próprio modelo faz | Uma geração; a geração seguinte recomeça do zero |
| Consistência de estilo | O visual: técnica, paleta, granulação | O filme inteiro, seja quem for que estiver no plano |
O primeiro e último quadro pode levar o último quadro de um plano para o primeiro quadro do seguinte: a emenda fica suave, mas o plano 12 continua sem saber do plano 3.
Referências de personagem no Veo, no Kling e no Seedance
Cada desenvolvedor de modelo tem a sua forma de fazer isso. O guia da Vertex AI do Google aceita até três imagens de uma única pessoa, personagem ou produto no Veo 3.1 e diz que o Veo preserva a aparência do elemento no vídeo; no modelo padrão, um clipe feito com imagens de elemento tem 8 segundos.
A Kling cria personagens como elementos. O guia da Element Library pede de duas a quatro imagens por elemento, uma principal e até três de outros ângulos, recomenda uma imagem principal de frente e diz que o Kling 3.0 vincula até três elementos a um quadro inicial.
O Seedance aceita muitas referências de uma vez, com uma regra que importa aqui: o tutorial da série Seedance 2.0 da BytePlus diz que esses modelos não aceitam imagens ou vídeos de referência que contenham diretamente rostos humanos reais e oferece, em vez disso, personagens digitais próprios e materiais autorizados de pessoas reais.
O que faz uma boa ficha de personagem
Um modelo copia o que uma referência mostra, queira você ou não, então uma boa ficha é simples de propósito:
- O mesmo rosto e o mesmo cabelo em todas as vistas, de frente, de lado e de costas, com o mesmo tom de pele em cada uma.
- Um personagem por ficha: um segundo rosto é uma segunda identidade para o modelo pegar emprestada.
- Um fundo liso, sem sombra projetada nem dominante de cor, que apareceriam em todos os planos.
- Sem textos, rótulos ou números, que um modelo pode escrever dentro do plano.
- Uma vista de frente nítida como imagem principal, como a Kling recomenda, com a roupa inteira visível.
- Lugares em fichas próprias, sem personagens.
Por que o rosto de um personagem muda entre planos
| Por que acontece | O que tentar | |
|---|---|---|
| A roupa muda de uma cena para outra | A roupa estava nas palavras de um plano e não do seguinte, ou não estava na referência | Mostre a roupa inteira na ficha e descreva-a com as mesmas palavras em todos os planos. |
| O rosto fica errado de lado ou de costas | A referência só mostrava a frente | Use uma ficha com vistas de lado e de costas, ou mantenha a câmera na frente do personagem. |
| O rosto se perde nos planos abertos | Um rosto com poucos pixels de altura carrega pouco da referência | Sustente a identidade em coisas que se leem de longe: cabelo, cores, um cachecol, um chapéu. |
| Mãos, óculos ou joias mudam | Os detalhes pequenos são gerados de novo a cada plano, e esquerda e direita se trocam com facilidade | Diga qual é o detalhe e de que lado ele fica, e mantenha menos detalhes. |
| O personagem parece mais velho ou mais novo | Luz, maquiagem e expressão mudam a idade aparente | Diga a idade com palavras em todos os planos e mantenha a luz parecida com a da ficha. |
| O cabelo cresce ou encurta | O comprimento não foi fixado, então ele varia com o movimento | Diga o comprimento exato: “chanel na altura do queixo”, não “cabelo curto”. |
| Dois personagens se misturam num só | Personagens parecidos compartilham traços pela mesma atenção | Deixe-os diferentes à primeira vista e dê a cada um uma ficha própria. |
Por que o meu personagem muda no meio de um plano? Isso é desvio dentro do clipe, uma falha de consistência temporal: um plano mais curto, menos movimento e um corte antes de uma virada grande ajudam mais do que uma nova referência.
Como manter o mesmo personagem em vídeo com IA: um checklist
- Crie o personagem uma vez, como ficha, antes de qualquer plano.
- Dê essa ficha a todos os planos em que ele aparece, ou comece cada plano a partir de uma imagem feita com ela.
- Escreva os poucos detalhes que o definem palavra por palavra em todos os prompts.
- Use um só modelo no filme inteiro quando puder: cada um lê uma referência do seu jeito.
- Compare imagens estáticas de planos diferentes lado a lado: uma mudança que passa despercebida em movimento fica evidente numa imagem parada.
Pessoas reais, imagem e consentimento
A imagem de referência de uma pessoa real é a imagem dela. Use a sua, ou a de alguém que deu permissão, e diga que o vídeo foi feito com IA quando ele puder passar por uma gravação real. Alguns modelos, entre eles o Seedance 2.0, recusam rostos reais de cara.
No DreamBench, as imagens enviadas são verificadas antes que qualquer crédito seja usado, e uma imagem que aparente mostrar uma pessoa real com menos de 18 anos é recusada: os Termos não permitem envios nem representações de pessoas reais com menos de 18 anos. No Morph, um vídeo com pessoas reais só é feito depois que você marca que é você, ou pessoas que deram permissão.
Como o DreamBench mantém um personagem igual em todos os planos
Quando você descreve um filme, o DreamBench escreve o roteiro e depois desenha o elenco antes de renderizar qualquer plano: cada personagem, lugar e objeto uma vez, como ficha, igual em todos os planos. Adicione uma imagem em “Quem aparece?”, marcada como personagem, criatura, cenário ou objeto, e essa ficha é desenhada a partir da sua imagem, pegando só o elemento, e não a luz ou o fundo dela; uma ficha que você já fez antes é usada como está.
Antes de desenhar uma ficha, cada personagem e objeto recebe uma trava de identidade: o rosto, o perfil, o corpo e o tamanho, escritos para o elenco inteiro de uma vez, para que dois personagens não tenham o mesmo rosto. Uma linha curta de identificadores tirada dela é escrita palavra por palavra em todos os planos que mostram o personagem, com a voz do personagem nos modelos que fazem som e o número de pessoas em cena.
A forma como uma ficha chega a um plano depende do modelo. No Seedance 2.5, no Seedance 2.0, no Veo 3.1 e no Vidu Q2, as fichas vão com cada plano como imagens de referência. Nos outros modelos, entre eles o Veo 3.1 Fast e Lite e o Kling 3.0, o DreamBench primeiro desenha uma imagem de abertura a partir das fichas do plano, e o plano começa dessa imagem.
Uma mudança de que a história precisa, como um personagem encharcado pela chuva, é desenhada como uma variante na ficha dele. Se você escolher revisar, conhece o elenco antes de qualquer plano ser gerado e pode desenhar qualquer ficha de novo, ou a partir de uma imagem sua. Um plano que ainda não ficou bom é refeito com uma observação dizendo o que corrigir.
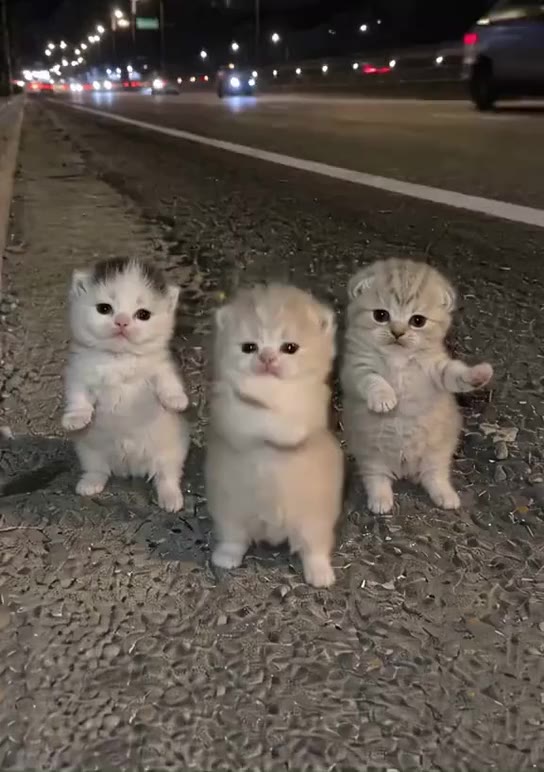 Original
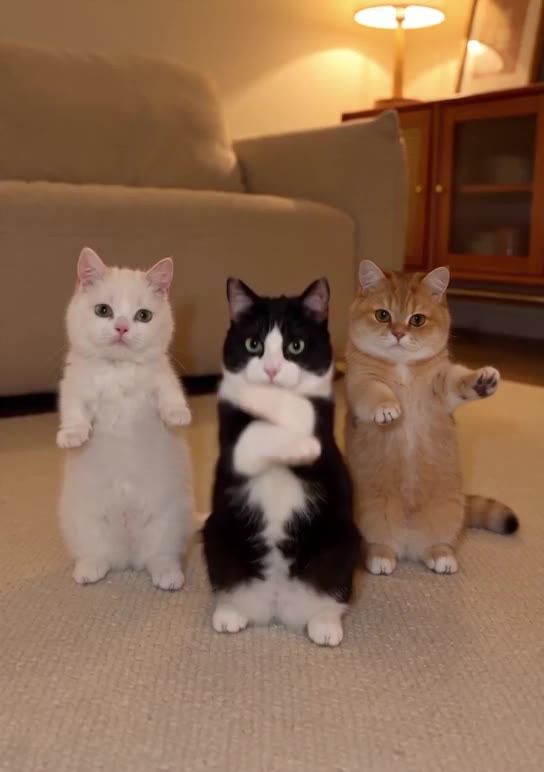 Com o Morph
Troque o fundo por @livingroom, com a disposição de @floorplan, mas troque os 3 gatos por @yickshuncat, @oreo e @mango.
Perguntas
Como manter o mesmo personagem em vídeo com IA?
Você mantém o mesmo personagem em vídeo com IA dando a todos os planos a mesma referência, de preferência uma ficha de personagem com vistas de frente, de lado e de costas, e escrevendo os mesmos poucos detalhes que o definem palavra por palavra em todos os prompts. Cada plano é uma geração separada, então tudo o que você não repete é reinventado.
Por que o rosto do meu personagem muda entre os planos?
O rosto de um personagem muda entre os planos porque o modelo de vídeo gera cada plano do zero e não se lembra de nada do anterior. Sem a mesma imagem de referência e a mesma descrição em todos os planos, ele inventa um rosto novo que combina com as palavras. Vistas de lado, de costas e rostos pequenos em planos abertos são os que mais mudam.
Como ter um personagem consistente no Kling?
No Kling, um personagem consistente é criado como elemento: o guia da Element Library da Kling pede de duas a quatro imagens, uma principal e até três de outros ângulos, com uma imagem principal de frente para mais consistência. No DreamBench, os planos do Kling 3.0 começam de uma imagem de abertura desenhada a partir das fichas do elenco.
O que é uma ficha de personagem em vídeo com IA?
Uma ficha de personagem é uma imagem de um personagem de vários ângulos, normalmente de frente, de lado e de costas, com o mesmo rosto, cabelo e roupa em todas as vistas, sobre um fundo liso. Cada plano a recebe como referência, para que o modelo saiba como o personagem fica quando se vira.
Usar a mesma seed mantém um personagem consistente?
Não. A mesma seed só repete um clipe com o mesmo prompt, a mesma duração, o mesmo formato e o mesmo modelo. Um plano novo muda pelo menos um desses itens, então o rosto também muda. Imagens de referência e a repetição das palavras mantêm um personagem; uma seed, não.
Qual é a diferença entre consistência de personagem e consistência temporal?
A consistência temporal acontece dentro de um clipe: se cada quadro concorda com o anterior. A consistência de personagem acontece entre clipes: se a pessoa no plano 2 é a mesma pessoa no plano 9. Um clipe pode ser estável e ainda assim mostrar a pessoa errada.
Quantas imagens de referência preciso para ter um personagem consistente?
Uma imagem nítida de frente é o mínimo, e algumas vistas do mesmo personagem costumam funcionar melhor, porque aí o modelo conhece o perfil e as costas. Os elementos da Kling recebem de duas a quatro imagens, e o Veo 3.1 do Google aceita até três imagens de um único elemento.
Posso usar uma foto minha como personagem num vídeo com IA?
Sim, quando o modelo aceita rostos reais: uma foto sua é a sua própria imagem, e uma foto nítida, de frente e com luz uniforme funciona melhor. Alguns modelos recusam rostos reais, entre eles o Seedance 2.0. No DreamBench, imagens que aparentem mostrar uma pessoa real com menos de 18 anos são recusadas.
Por que o Seedance recusa a minha foto de referência?
O Seedance recusa uma foto de referência quando identifica nela um rosto humano real: a BytePlus diz que os modelos da série Seedance 2.0 não aceitam imagens ou vídeos de referência que contenham diretamente rostos humanos reais e oferece, em vez disso, personagens digitais predefinidos e materiais autorizados de pessoas reais.
Por que a roupa do meu personagem muda entre as cenas?
A roupa muda entre as cenas quando ela não está na referência ou num prompt, então o modelo preenche a lacuna com o que combinar com a cena. Mostre a roupa inteira na ficha, descreva-a do mesmo jeito em todos os planos e dê a uma roupa nova uma ficha própria.
A IA consegue manter dois personagens consistentes na mesma cena?
Sim, com uma referência para cada um: dê a cada personagem uma ficha própria e cite cada um pelo nome no prompt, para que o modelo saiba qual imagem é qual pessoa. Personagens parecidos podem se misturar, então deixe-os diferentes à primeira vista.
O DreamBench mantém os personagens consistentes ao longo de um filme inteiro?
Sim. O DreamBench desenha cada personagem, lugar e objeto uma vez, como ficha, antes de renderizar qualquer plano, escreve os identificadores de cada personagem palavra por palavra em todos os planos e dá a cada plano as suas fichas como referências ou como imagem de abertura, conforme o modelo.
Relacionados
Ferramentas do DreamBench
Páginas de modelos
- Seedance 2.5Conte uma história curta em um clipe de até 30 segundos, dividido em planos encadeados, com som criado junto com a imagem.
- Veo 3.1Dê forma a cenas realistas em widescreen ou na vertical, com diálogos e som, no Veo 3.1, no Fast ou no Lite.
- Kling 3.0Coloque o movimento em foco, de esportes e dança a veículos, com diálogo em sincronização labial em 5 idiomas.
Termos
- Consistência temporalO quanto um vídeo com IA mantém as coisas iguais de um quadro para outro, sem cintilação nem desvio.
- Imagem para vídeoVídeo com IA que parte de uma imagem estática, com o movimento gerado a partir de um prompt.
- Referência para vídeoVídeo com IA que mantém reconhecível, num plano novo, um personagem, produto ou lugar das suas imagens.
- Primeiro e último quadroVídeo com IA que começa numa imagem e termina em outra, com o movimento entre elas gerado pelo modelo.
- Vídeo com vários planosUm vídeo com IA de vários planos unidos por cortes: planejado como uma lista de planos, gerado plano a plano, montado em um só filme.
- Áudio nativoSom que um modelo de vídeo faz junto com a imagem: diálogo, efeitos e ambiente em uma só linha do tempo.
Fontes
- Gerar vídeos do Veo a partir de imagens de referênciaGoogle Cloud, consultado em
- Guia do usuário da Element Library da KlingKling AI, consultado em
- Tutorial da série Dreamina Seedance 2.0: criar vídeos de retratoBytePlus, consultado em
- IP-Adapter: Text Compatible Image Prompt Adapter for Text-to-Image Diffusion ModelsarXiv, consultado em
- InstantID: Zero-shot Identity-Preserving Generation in SecondsarXiv, consultado em
- DreamBooth: Fine Tuning Text-to-Image Diffusion Models for Subject-Driven GenerationarXiv, consultado em
- LoRA: Low-Rank Adaptation of Large Language ModelsarXiv, consultado em
- StoryDiffusion: Consistent Self-Attention for Long-Range Image and Video GenerationarXiv, consultado em
O DreamBench é uma plataforma independente e não é afiliado às empresas citadas nesta página nem endossado por elas.