KI-Videogenerierung
Was ist Figurenkonsistenz bei KI-Videos?
Figurenkonsistenz beschreibt, wie gut ein KI-Video dieselbe Figur von einer Einstellung zur nächsten als dieselbe Person, dasselbe Wesen oder dasselbe Maskottchen erhält: dasselbe Gesicht, dieselben Haare, dieselbe Statur, dieselbe Kleidung und dieselbe Stimme. Jede Einstellung ist eine eigene Generierung; ohne Referenzen oder ein Charakterblatt erfindet das Modell die Figur also jedes Mal neu.
Vom DreamBench-Team. Aktualisiert am .
Figurenkonsistenz auf einen Blick
Auf einen Blick
- Bedeutet
- Dieselbe Figur ist in Einstellung 1 und Einstellung 30 erkennbar dieselbe, egal welcher Ort, welches Licht, welche Kamera.
- Umfasst
- Gesicht, Haare, Körper, Kleidung und Requisiten, die sie tragen, und bei Modellen mit Ton die Stimme.
- Warum es schwer ist
- Ein Videomodell macht eine Einstellung nach der anderen und merkt sich nichts von der vorigen.
- Was sie trägt
- Dieselben Referenzbilder, am besten ein Charakterblatt, und dieselben Worte in jeder Einstellung.
- Nicht dasselbe wie
- Zeitliche Konsistenz, bei der es darum geht, dass Frames innerhalb eines Clips übereinstimmen.
- Bricht zuerst bei
- Seiten- und Rückansichten, kleinen Gesichtern in Totalen, Händen und wechselnder Kleidung.
Charakterblatt
Vorn
Seite
Zurück
Einmal gezeichnet: dasselbe Gesicht, dieselben Haare, derselbe Mantel und Schal in jeder Ansicht, auf schlichtem Grund, ohne Schatten und ohne andere Personen.
Jede Einstellung
Einstellung 1: Totale, eine Straße bei Nacht
Einstellung 2: Halbnah, ein Wald
Einstellung 3: Großaufnahme, drinnen
Einstellung 4: Totale, ein Strand bei Tag
Was mit jeder Einstellung mitgeht
- Das Blatt, als Referenzbild oder als Startbild
- Dieselben Merkmale, Wort für Wort, in jedem Prompt
- Dieselbe Stimme, bei Modellen, die Ton erzeugen
Neuer Ort, neues Licht, neuer Bildausschnitt: Die Figur bleibt dieselbe Person, weil jede Einstellung dasselbe Blatt und dieselben Worte bekommt, nicht weil sich das Modell an die letzte Einstellung erinnert.
Wie KI eine Figur über Einstellungen hinweg gleich hält
Ein Videomodell macht einen Film Einstellung für Einstellung, und nichts geht von Einstellung 4 auf Einstellung 5 über, wenn du es nicht weitergibst: Das Modell beginnt wieder bei Rauschen und erfindet, was der Prompt offenlässt. Schreib zweimal „eine Frau mit kurzen blonden Haaren“, und du bekommst zwei verschiedene Frauen.
Konsistenz entsteht also aus dem, was jede Einstellung mitbekommt. Dieselben Worte helfen. Ein Bild hilft mehr, denn ein Gesicht lässt sich leichter zeigen als beschreiben: Modelle, die eines annehmen, der Modus namens Referenz-zu-Video, halten Gesicht, Haare und Farben, die sie sehen. Ein Charakterblatt, die Figur von vorn, von der Seite und von hinten, hilft am meisten, weil es sie auch umgedreht zeigt.
Eine Einstellung mit einem Bild der Figur zu beginnen, wie es Bild-zu-Video tut, funktioniert auch: Der erste Frame ist festgelegt, und je weiter sich die Einstellung davon entfernt, desto mehr wird wieder erfunden.
Unter der Haube: Referenzen, Identitäts-Embeddings und Seeds
Ein Referenzbild erreicht das Modell über Attention, denselben Mechanismus, den der Text nutzt. IP-Adapter fügt ein Bild als Prompt über eigene Cross-Attention-Schichten hinzu, getrennt von denen des Textes, in einem Adapter mit etwa 22 Millionen Parametern, während das Modell selbst unverändert bleibt.
Identitätsmethoden gehen weiter und kodieren das Gesicht selbst. InstantID arbeitet mit einem einzigen Foto eines Gesichts: Ein separates Netz steuert die Generierung mit den Merkmalen und Landmarken dieses Gesichts, sodass die Person erkennbar bleibt, während sich Stil und Pose ändern. Dieses kodierte Gesicht ist ein Identitäts-Embedding.
Der älteste Weg ist, dem Modell die Figur beizubringen. DreamBooth feintunt ein Modell mit wenigen Bildern eines Motivs, bis es ein eindeutiges Wort daran bindet, und generiert dieses Motiv dann in neuen Szenen, Posen, Ansichten und Lichtverhältnissen. LoRA, zuerst für Sprachmodelle veröffentlicht, macht ein solches Feintuning leicht: Die eigenen Gewichte des Modells bleiben eingefroren, und nur kleine zusätzliche Matrizen werden trainiert. Beides braucht ein Modell, dessen Gewichte du trainieren kannst.
Eine andere Idee ist, die Bilder gemeinsam zu generieren. StoryDiffusion teilt Attention über einen Stapel von Bildern, ohne Training, sodass ein Motiv über eine Serie übereinstimmt; Videomodelle mit mehreren Einstellungen halten eine Besetzung auf ähnliche Weise über ihre eigenen Schnitte, aber nur innerhalb einer Generierung.
Warum trägt der Seed die Figur nicht? Ein Seed legt das Ausgangsrauschen fest, sodass derselbe Seed mit demselben Prompt, derselben Länge, demselben Format und demselben Modell denselben Clip wiederholt. Eine neue Einstellung ändert mindestens eines davon, dasselbe Rauschen wird neu gelesen, und das letzte Gesicht ist nirgends gespeichert.
Referenzbild, Charakterblatt, Seed oder LoRA: was jedes hält
| Was erhalten bleibt | Was es verliert | |
|---|---|---|
| Dieselbe Beschreibung in jedem Prompt | Die groben Züge: Haarfarbe, Alter, Outfit | Das Gesicht. Worte können keines festnageln, und eine neue Formulierung wird als neue Person gelesen. |
| Derselbe Seed | Denselben Clip noch einmal, aus demselben Prompt und denselben Einstellungen | Alles, sobald sich Prompt, Länge, Format oder Modell ändern. |
| Ein Referenzbild | Gesicht und Farben, die das Bild zeigt | Blickwinkel, die es nicht zeigt, und manchmal kommen Licht und Hintergrund mit. |
| Ein Charakterblatt | Gesicht, Haare, Statur und Outfit aus mehreren Blickwinkeln | Alles, was nicht auf dem Blatt ist: ein neues Outfit, ein späteres Alter, ein Gesicht, das in einer Totalen zu klein ist, um es zu erkennen. |
| Ein Startbild | Das Bild exakt, bei Sekunde null | Was der Frame nicht zeigt; die Drift wächst, je weiter die Einstellung läuft. |
| Ein Identitäts-Adapter | Ein Gesicht aus einem Foto, über Stile und Posen hinweg | Kleidung und Körper; es braucht ein Modell, das dafür gebaut ist, einen anzunehmen. |
| Ein Feintuning (DreamBooth, LoRA) | Ein aus mehreren Bildern gelerntes Motiv, in neuen Posen, Ansichten und Lichtverhältnissen | Zeit: Training für jede Figur, mit einem Modell, dessen Gewichte du trainieren kannst. |
Figurenkonsistenz vs. zeitliche Konsistenz
Beide enden in einem Gesicht, das sich verändert, deshalb verwechselt man sie leicht. Zeitliche Konsistenz gilt innerhalb eines Clips: Stimmt Frame 90 mit Frame 1 überein? Figurenkonsistenz gilt über Clips hinweg: Ist die Frau in der Küche in Einstellung 2 dieselbe Frau wie die im Zug in Einstellung 9? Ein stabiler Clip kann trotzdem die falsche Person zeigen.
Konsistent
Dieselbe Figur, Farbe und Größe, Frame für Frame; nur die Bewegung ändert sich.
Abdriftend
Markierte Frames: ein Blitz in der falschen Farbe (Flackern), dann eine Figur, die allmählich zu jemand anderem wird (Identitätsdrift).
| Was gleich bleibt | Worüber hinweg | |
|---|---|---|
| Figurenkonsistenz | Wer jemand ist: Gesicht, Haare, Statur, Kleidung, Stimme | Jede Einstellung und Szene eines Films |
| Zeitliche Konsistenz | Alles im Bild | Von einem Frame zum nächsten, innerhalb eines Clips |
| Referenz-zu-Video | Ein Motiv aus den Bildern, die du vorgibst | Eine Einstellung; in jeder Einstellung wiederholt, ist es der Weg, wie die meisten Filme Figurenkonsistenz erreichen |
| Start- und Endbild | Die beiden Enden einer Einstellung | Eine Einstellung: Es legt eine Pose fest, keine Identität über einen ganzen Film |
| Video mit mehreren Einstellungen | Die Besetzung über die Schnitte, die das Modell selbst setzt | Eine Generierung; die nächste Generierung beginnt von vorn |
| Stilkonsistenz | Der Look: Medium, Farbpalette, Körnung | Der ganze Film, egal wer in der Einstellung ist |
Start- und Endbild kann den letzten Frame einer Einstellung zum ersten Frame der nächsten machen: Der Übergang ist fließend, aber Einstellung 12 weiß trotzdem nichts von Einstellung 3.
Figurenreferenzen bei Veo, Kling und Seedance
Jeder Modellhersteller hat seinen eigenen Weg. Googles Leitfaden zu Vertex AI nimmt für Veo 3.1 bis zu drei Bilder einer einzelnen Person, Figur oder eines Produkts und sagt, dass Veo das Aussehen des Motivs im Video bewahrt; beim Standardmodell ist ein Clip mit Motivbildern 8 Sekunden lang.
Kling baut Figuren als Elements. Sein Leitfaden zur Element Library verlangt zwei bis vier Bilder pro Element, ein Hauptbild und bis zu drei aus anderen Blickwinkeln, empfiehlt ein frontales Hauptbild und sagt, dass Kling 3.0 bis zu drei Elements an ein Startbild bindet.
Seedance nimmt viele Referenzen auf einmal, mit einer Regel, auf die es hier ankommt: Das Tutorial zur Seedance-2.0-Serie von BytePlus sagt, dass diese Modelle keine Referenzbilder oder -videos annehmen, die direkt echte menschliche Gesichter enthalten, und bietet stattdessen eigene digitale Figuren und autorisierte Assets echter Personen an.
Was ein gutes Charakterblatt ausmacht
Ein Modell kopiert, was eine Referenz zeigt, ob gewollt oder nicht; ein gutes Blatt ist also absichtlich schlicht:
- Dasselbe Gesicht und dieselben Haare in jeder Ansicht, vorn, seitlich und hinten, die Haut in jeder im selben Ton.
- Eine Figur pro Blatt: Ein zweites Gesicht ist eine zweite Identität, bei der sich das Modell bedienen kann.
- Ein schlichter Grund ohne Schlagschatten oder Farbstich, die sonst in jeder Einstellung auftauchen würden.
- Kein Text, keine Beschriftungen oder Zahlen, die ein Modell in die Einstellung schreiben könnte.
- Eine klare Vorderansicht als Hauptbild, wie Kling empfiehlt, mit dem ganzen Outfit sichtbar.
- Orte auf eigenen Blättern, ohne Figuren.
Warum sich das Gesicht einer Figur zwischen Einstellungen ändert
| Warum es passiert | Was du versuchen kannst | |
|---|---|---|
| Die Kleidung ändert sich von Szene zu Szene | Das Outfit stand in den Worten einer Einstellung und nicht in denen der nächsten, oder nicht auf der Referenz | Zeig das ganze Outfit auf dem Blatt und benenne es in jeder Einstellung mit denselben Worten. |
| Das Gesicht stimmt von der Seite oder von hinten nicht | Die Referenz zeigte nur die Vorderseite | Nimm ein Blatt mit Seiten- und Rückansichten, oder halte die Kamera vor der Figur. |
| Das Gesicht geht in Totalen verloren | Ein Gesicht, das nur ein paar Pixel hoch ist, trägt wenig von der Referenz | Mach die Identität an Dingen fest, die auch klein erkennbar sind: Haare, Farben, ein Schal, ein Hut. |
| Hände, Brille oder Schmuck ändern sich | Kleine Details werden in jeder Einstellung neu generiert, und links und rechts werden leicht vertauscht | Nenne das Detail und auf welcher Seite es ist, und behalte weniger davon. |
| Die Figur wirkt älter oder jünger | Licht, Make-up und Ausdruck verschieben das scheinbare Alter | Nenne das Alter in jeder Einstellung in Worten und halte das Licht nah an dem des Blatts. |
| Die Haare werden länger oder kürzer | Die Länge war nicht festgelegt, also driftet sie mit der Bewegung | Nenne die Länge genau: „kinnlanger Bob“, nicht „kurze Haare“. |
| Zwei Figuren verschmelzen zu einer | Ähnliche Figuren teilen Merkmale über dieselbe Attention | Mach sie auf den ersten Blick unterschiedlich und gib jeder ein eigenes Blatt. |
Warum ändert sich meine Figur mitten in einer Einstellung? Das ist Drift innerhalb des Clips, ein Versagen der zeitlichen Konsistenz: Eine kürzere Einstellung, weniger Bewegung und ein Schnitt vor einer großen Drehung helfen mehr als eine neue Referenz.
So hältst du dieselbe Figur im KI-Video: eine Checkliste
- Erstelle die Figur einmal, als Blatt, vor jeder Einstellung.
- Gib dieses Blatt jeder Einstellung mit, in der sie vorkommt, oder beginne jede Einstellung mit einem Bild, das daraus gemacht ist.
- Schreib ihre wenigen prägenden Details in jedem Prompt Wort für Wort.
- Nimm für den ganzen Film nach Möglichkeit ein Modell: Jedes liest eine Referenz auf seine eigene Weise.
- Vergleiche Standbilder aus verschiedenen Einstellungen nebeneinander: Eine Veränderung, die dir in Bewegung entgeht, ist in Standbildern deutlich.
Echte Personen, Abbild und Einwilligung
Ein Referenzbild einer echten Person ist ihr Abbild. Verwende dein eigenes oder eines von jemandem, der dir die Erlaubnis gegeben hat, und sag, dass das Video mit KI erstellt ist, wenn es für echte Aufnahmen gehalten werden könnte. Manche Modelle, darunter Seedance 2.0, lehnen echte Gesichter grundsätzlich ab.
Auf DreamBench werden hochgeladene Bilder geprüft, bevor ein Credit verbraucht wird, und ein Bild, das eine echte Person unter 18 zu zeigen scheint, wird abgelehnt: Die Nutzungsbedingungen erlauben keine Uploads oder Darstellungen echter Personen unter 18. In Morph wird ein Video mit echten Personen erst erstellt, nachdem du bestätigt hast, dass du es bist oder Personen, die ihre Erlaubnis gegeben haben.
So hält DreamBench eine Figur in jeder Einstellung gleich
Wenn du einen Film beschreibst, schreibt DreamBench das Drehbuch und zeichnet dann die Besetzung, bevor eine einzige Einstellung gerendert wird: jede Figur, jeden Ort und jede Requisite einmal, als Blatt, in jeder Einstellung gleich. Füg unter „Wer ist zu sehen?“ ein Bild hinzu, getaggt als Figur, Kreatur, Schauplatz oder Requisite, und das Blatt wird aus deinem Bild gezeichnet, mit dem Motiv allein, ohne sein Licht oder seinen Hintergrund; ein Blatt, das du schon gemacht hast, wird so verwendet, wie es ist.
Bevor ein Blatt gezeichnet wird, bekommt jede Figur und jede Requisite eine Identitätssperre: Gesicht, Profil, Körper und Größe, für die ganze Besetzung auf einmal geschrieben, damit keine zwei Figuren ein Gesicht teilen. Eine kurze Zeile mit Merkmalen daraus wird Wort für Wort in jede Einstellung geschrieben, in der die Figur vorkommt, zusammen mit der Stimme der Figur bei Modellen, die Ton erzeugen, und der Zahl der Personen im Bild.
Wie ein Blatt in eine Einstellung gelangt, hängt vom Modell ab. Bei Seedance 2.5, Seedance 2.0, Veo 3.1 und Vidu Q2 gehen die Blätter als Referenzbilder mit jeder Einstellung mit. Bei den anderen Modellen, darunter Veo 3.1 Fast und Lite sowie Kling 3.0, zeichnet DreamBench zuerst aus den Blättern der Einstellung ein Startbild, und die Einstellung beginnt mit diesem Bild.
Eine Veränderung, die die Geschichte braucht, etwa eine vom Regen durchnässte Figur, wird als Variante auf ihrem eigenen Blatt gezeichnet. Wenn du die Prüfung wählst, lernst du die Besetzung kennen, bevor irgendetwas gedreht wird, und kannst jedes Blatt neu zeichnen lassen, auch aus einem eigenen Bild. Eine Einstellung, die dann noch nicht passt, wird mit einer Notiz neu gedreht, die sagt, was zu korrigieren ist.
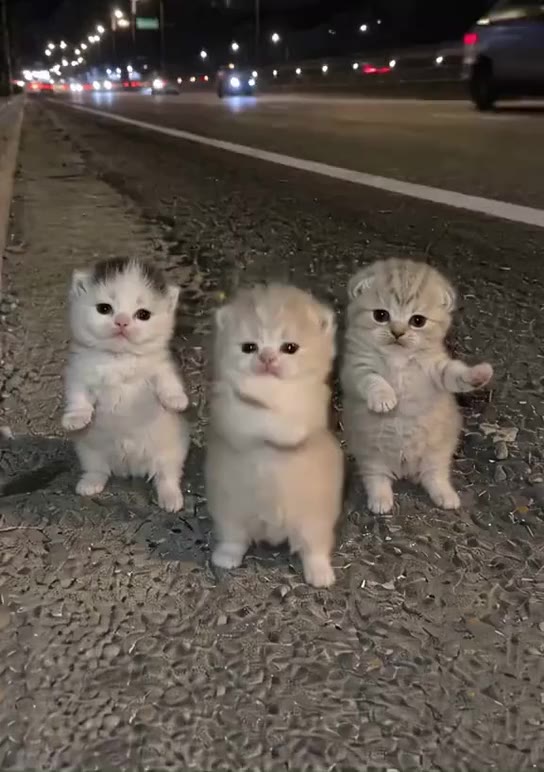 Original
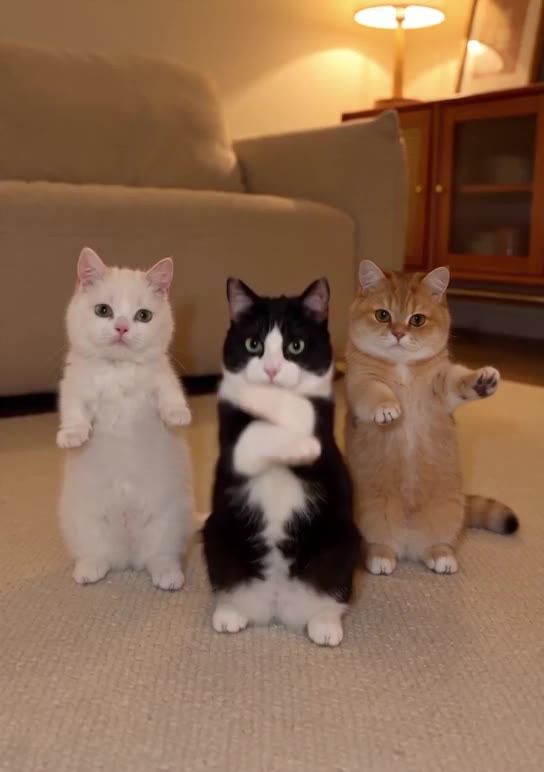 Mit Morph
Ändere den Hintergrund zu @livingroom, angeordnet wie in @floorplan, aber tausche die 3 Katzen gegen @yickshuncat, @oreo und @mango.
Fragen
Wie hält man dieselbe Figur im KI-Video?
Du hältst dieselbe Figur im KI-Video, indem du jeder Einstellung dieselbe Referenz mitgibst, am besten ein Charakterblatt mit Ansichten von vorn, von der Seite und von hinten, und dieselben wenigen prägenden Details Wort für Wort in jeden Prompt schreibst. Jede Einstellung ist eine eigene Generierung; was du nicht wiederholst, wird neu erfunden.
Warum ändert sich das Gesicht meiner Figur zwischen Einstellungen?
Das Gesicht einer Figur ändert sich zwischen Einstellungen, weil das Videomodell jede Einstellung von Grund auf generiert und sich nichts von der vorigen merkt. Ohne dasselbe Referenzbild und dieselbe Beschreibung in jeder Einstellung erfindet es ein neues Gesicht, das zu den Worten passt. Seitenansichten, Rückansichten und kleine Gesichter in Totalen driften am stärksten.
Wie bekomme ich eine konsistente Figur in Kling?
In Kling entsteht eine konsistente Figur als Element: Klings Leitfaden zur Element Library verlangt zwei bis vier Bilder, ein Hauptbild und bis zu drei aus anderen Blickwinkeln, mit einem frontalen Hauptbild für höhere Konsistenz. Auf DreamBench beginnen Einstellungen mit Kling 3.0 mit einem Startbild, das aus den Blättern der Besetzung gezeichnet wird.
Was ist ein Charakterblatt im KI-Video?
Ein Charakterblatt ist ein Bild einer Figur aus mehreren Blickwinkeln, meist von vorn, von der Seite und von hinten, mit demselben Gesicht, denselben Haaren und demselben Outfit in jeder Ansicht auf schlichtem Grund. Jede Einstellung bekommt es als Referenz, sodass das Modell weiß, wie die Figur aussieht, wenn sie sich umdreht.
Hält derselbe Seed eine Figur konsistent?
Nein. Derselbe Seed wiederholt einen Clip nur mit demselben Prompt, derselben Länge, demselben Format und demselben Modell. Eine neue Einstellung ändert mindestens eines davon, also ändert sich auch das Gesicht. Referenzbilder und wiederholte Formulierungen halten eine Figur; ein Seed nicht.
Was ist der Unterschied zwischen Figurenkonsistenz und zeitlicher Konsistenz?
Zeitliche Konsistenz gilt innerhalb eines Clips: ob jeder Frame mit dem vorigen übereinstimmt. Figurenkonsistenz gilt über Clips hinweg: ob die Person in Einstellung 2 dieselbe Person ist wie in Einstellung 9. Ein Clip kann stabil sein und trotzdem die falsche Person zeigen.
Wie viele Referenzbilder brauche ich für eine konsistente Figur?
Ein klares, frontales Bild ist das Minimum, und einige Ansichten derselben Figur halten meist besser, weil das Modell dann das Profil und die Rückseite kennt. Klings Elements nehmen zwei bis vier Bilder, und Googles Veo 3.1 nimmt bis zu drei Bilder eines einzelnen Motivs.
Kann ich ein Foto von mir als Figur im KI-Video verwenden?
Ja, sofern das Modell echte Gesichter annimmt: Ein Foto von dir ist dein eigenes Abbild, und ein klares, frontales, gleichmäßig ausgeleuchtetes Bild funktioniert am besten. Manche Modelle lehnen echte Gesichter ab, darunter Seedance 2.0. Auf DreamBench werden Bilder abgelehnt, die eine echte Person unter 18 zu zeigen scheinen.
Warum lehnt Seedance mein Referenzfoto ab?
Seedance lehnt ein Referenzfoto ab, wenn es darin ein echtes menschliches Gesicht erkennt: Laut BytePlus nehmen die Modelle der Seedance-2.0-Serie keine Referenzbilder oder -videos an, die direkt echte menschliche Gesichter enthalten, und bieten stattdessen voreingestellte digitale Figuren und autorisierte Assets echter Personen an.
Warum ändert sich die Kleidung meiner Figur zwischen Szenen?
Die Kleidung ändert sich zwischen Szenen, wenn das Outfit in der Referenz oder in einem Prompt fehlt, sodass das Modell die Lücke mit dem füllt, was zur Szene passt. Zeig das ganze Outfit auf dem Blatt, benenne es in jeder Einstellung gleich und gib einem neuen Outfit ein eigenes Blatt.
Kann KI zwei Figuren in derselben Szene konsistent halten?
Ja, mit einer Referenz für jede: Gib jeder Figur ein eigenes Blatt und nenne jede im Prompt, damit das Modell weiß, welches Bild welche Person ist. Figuren, die sich ähneln, können verschmelzen, also mach sie auf den ersten Blick unterschiedlich.
Hält DreamBench Figuren über einen ganzen Film konsistent?
Ja. DreamBench zeichnet jede Figur, jeden Ort und jede Requisite einmal als Blatt, bevor eine Einstellung gerendert wird, schreibt die Merkmale jeder Figur Wort für Wort in jede Einstellung und gibt jeder Einstellung je nach Modell ihre Blätter als Referenzen oder als Startbild mit.
Passend dazu
Auf DreamBench
DreamBench-Tools
Modellseiten
- Seedance 2.5Erzähl eine kurze Geschichte in einem Clip von bis zu 30 Sekunden, aufgeteilt in zusammenhängende Einstellungen, mit Ton, der mit dem Bild entsteht.
- Veo 3.1Gestalte realistische Szenen im Breit- oder Hochformat mit Dialog und Ton, mit Veo 3.1, Fast oder Lite.
- Kling 3.0Stell Bewegung in den Mittelpunkt, von Sport und Tanz bis zu Fahrzeugen, mit lippensynchronen Dialogen in 5 Sprachen.
Begriffe
- Zeitliche KonsistenzWie gut ein KI-Video Dinge von Frame zu Frame gleich hält, ohne Flackern oder Abdriften.
- Bild zu VideoKI-Video, das von einem Standbild ausgeht; die Bewegung entsteht aus einem Prompt.
- Referenz-zu-VideoKI-Video, das eine Figur, ein Produkt oder einen Ort aus deinen Bildern in einer neuen Einstellung erkennbar hält.
- Start- und EndbildKI-Video, das mit einem Bild beginnt und mit einem anderen endet, die Bewegung dazwischen generiert.
- Video mit mehreren EinstellungenEin KI-Video aus mehreren Einstellungen, verbunden durch Schnitte: als Shotlist geplant, Einstellung für Einstellung generiert, zu einem Film geschnitten.
- Natives AudioTon, den ein Videomodell mit dem Bild erzeugt: Dialog, Effekte und Atmosphäre auf einer Zeitleiste.
Quellen
- Veo-Videos aus Referenzbildern generierenGoogle Cloud, abgerufen am
- Benutzerhandbuch zur Element Library von KlingKling AI, abgerufen am
- Tutorial zur Dreamina-Seedance-2.0-Serie: Porträtvideos erstellenBytePlus, abgerufen am
- IP-Adapter: Text Compatible Image Prompt Adapter for Text-to-Image Diffusion ModelsarXiv, abgerufen am
- InstantID: Zero-shot Identity-Preserving Generation in SecondsarXiv, abgerufen am
- DreamBooth: Fine Tuning Text-to-Image Diffusion Models for Subject-Driven GenerationarXiv, abgerufen am
- LoRA: Low-Rank Adaptation of Large Language ModelsarXiv, abgerufen am
- StoryDiffusion: Consistent Self-Attention for Long-Range Image and Video GenerationarXiv, abgerufen am
DreamBench ist eine unabhängige Plattform, die mit den auf dieser Seite genannten Unternehmen nicht verbunden ist und von ihnen nicht unterstützt wird.