AI動画生成
AI動画のキャラクターの一貫性とは?
キャラクターの一貫性とは、AI動画があるショットから次のショットへ、同じキャラクターを同じ人物、生き物、マスコットとしてどれだけ保てるかのことです。顔、髪、体型、服、声が同じであること。各ショットは別々の生成なので、参照画像やキャラクター設定シートがなければ、モデルは毎回キャラクターを作り直します。
執筆:DreamBenchチーム。更新。
キャラクターの一貫性の概要
概要
- 意味
- 場所、光、カメラが変わっても、ショット1とショット30で同じキャラクターがひと目で同じとわかること。
- 対象
- 顔、髪、体、服、持っている小道具。サウンドのあるモデルでは声も。
- 難しい理由
- 動画モデルは一度に1つのショットを作り、前のショットのことは何も覚えていません。
- 何で保つか
- 同じ参照画像(できればキャラクター設定シート)と、すべてのショットで同じ言葉。
- 混同しやすいもの
- 時間的一貫性。こちらは1つのクリップの中で、フレームどうしが一致するかどうかの話です。
- 最初に崩れやすいところ
- 横や後ろからの姿、ワイドショットの小さな顔、手、変わってしまう服。
キャラクター設定シート
正面
横
戻る
一度だけ描く:どの向きでも同じ顔、髪、コート、マフラー。影のない無地の背景に、ほかには誰もいない。
すべてのショット
ショット1:ワイド、夜の通り
ショット2:ミディアム、森
ショット3:クローズアップ、屋内
ショット4:ワイド、昼間の浜辺
すべてのショットに添えるもの
- 参照画像または開始の静止画としての設定シート
- すべてのプロンプトで、一字一句同じ識別子
- サウンド付きのモデルなら、同じ声
新しい場所、新しい光、新しいフレーミング。キャラクターが同じ人物のままなのは、モデルが前のショットを覚えているからではなく、すべてのショットに同じ設定シートと同じ言葉を渡しているからです。
AIがショットをまたいでキャラクターを同じに保つ仕組み
動画モデルは映像を1ショットずつ作り、あなたが渡さないかぎり、ショット4からショット5へは何も引き継がれません。モデルはノイズから作り直し、プロンプトで決まっていない部分は何でも作り出します。「短い金髪の女性」と2回書けば、2人の別々の女性が出てきます。
ですから一貫性は、すべてのショットに何を渡すかで決まります。同じ言葉は役立ちます。画像はもっと役立ちます。顔は説明するより見せるほうが簡単だからです。画像を受け取るモデル、つまり参照画像から動画生成と呼ばれるモードでは、見える顔、髪、色が保たれます。いちばん役立つのはキャラクター設定シート、つまり正面、横、後ろから見たキャラクターです。振り向いたときの姿も見せられるからです。
画像から動画生成のように、キャラクターの画像からショットを始める方法も使えます。最初のフレームは固定されますが、ショットがそこから離れるほど、多くが作り直されます。
仕組み:参照画像、アイデンティティ埋め込み、シード
参照画像は、テキストと同じ仕組みであるアテンションを通じてモデルに届きます。IP-Adapterは、テキスト用とは別の独自のクロスアテンション層を通じて、画像をプロンプトとして加えます。約2,200万(22M)パラメーターのアダプターで、モデル本体は変更しません。
アイデンティティ系の手法はさらに進んで、顔そのものをエンコードします。InstantIDは顔写真1枚から動作し、別のネットワークがその顔の特徴とランドマークで生成を導くので、スタイルやポーズが変わっても人物を見分けられます。そうしてエンコードされた顔が、アイデンティティ埋め込みです。
いちばん古い方法は、モデルにキャラクターを教え込むことです。DreamBoothは、被写体の画像数枚でモデルをファインチューニングし、固有の単語をその被写体に結びつけたうえで、新しい場面、ポーズ、視点、光でその被写体を生成します。もともと言語モデル向けに発表されたLoRAは、そうしたファインチューニングを軽くします。モデル自体の重みは固定したまま、追加した小さな行列だけを学習させます。どちらも、重みを学習させられるモデルが必要です。
別の考え方は、画像をまとめて生成することです。StoryDiffusionは学習なしで画像のバッチ全体でアテンションを共有し、一連の画像で被写体を一致させます。マルチショットの動画モデルも、似た方法で自分のカットをまたいでキャストを保ちますが、それは1回の生成の中だけです。
なぜシードではキャラクターを引き継げないのでしょうか?シードは初期ノイズを固定するので、同じシードで同じプロンプト、長さ、フレーム、モデルなら、同じクリップが繰り返されます。新しいショットではそのうち少なくとも1つが変わり、同じノイズが新しい形で読まれます。そして前の顔は、どこにも保存されていません。
参照画像、キャラクター設定シート、シード、LoRA:それぞれが保つもの
| 保つもの | 失われるもの | |
|---|---|---|
| すべてのプロンプトで同じ説明 | 大まかな特徴:髪の色、年齢、服装 | 顔。言葉では1つの顔に絞り込めず、言い回しが変わると別人として読まれます。 |
| 同じシード | 同じプロンプトと設定からの、同じクリップの再現 | プロンプト、長さ、フレーム、モデルのどれかが変わった時点で、すべて。 |
| 参照画像1枚 | 画像に写っている顔と色 | 写っていない角度。画像の光や背景までついてくることもあります。 |
| キャラクター設定シート | 複数の角度から見た顔、髪、体型、服装 | 設定シートにないものすべて:新しい服装、年を重ねた姿、ワイドショットで小さすぎて読み取れない顔。 |
| 最初のフレーム | 0秒時点の画像そのもの | フレームに写っていないもの。ショットが進むほどずれが大きくなります。 |
| アイデンティティアダプター | 写真1枚からの顔を、スタイルやポーズをまたいで | 服と体。対応するよう作られたモデルが必要です。 |
| ファインチューニング(DreamBooth、LoRA) | 複数の画像から学習した被写体を、新しいポーズ、視点、光で | 時間:キャラクターごとの学習が必要で、重みを学習させられるモデルでしかできません。 |
キャラクターの一貫性と時間的一貫性の違い
どちらも顔が変わるという結果になるので、混同しやすいものです。時間的一貫性は1つのクリップの中の話です。フレーム90はフレーム1と一致しているか。キャラクターの一貫性はクリップをまたぐ話です。ショット2でキッチンにいる女性は、ショット9で電車に乗っている女性と同じ人か。安定したクリップでも、違う人物が映っていることはあります。
一貫性あり
フレームが進んでも同じ形、色、大きさ。変わるのは動きだけ。
ずれていく
印を付けたフレーム:間違った色が一瞬光り(ちらつき)、その後、人物が少しずつ別人になっていく(アイデンティティのずれ)。
| 同じに保たれるもの | 範囲 | |
|---|---|---|
| キャラクターの一貫性 | その人が誰か:顔、髪、体型、服、声 | 映像のすべてのショットとシーン |
| 時間的一貫性 | フレーム内のすべて | 1つのクリップの中で、あるフレームから次のフレームへ |
| 参照画像から動画生成 | あなたが渡した画像の被写体 | 1つのショット。すべてのショットで繰り返すことが、多くの映像でキャラクターの一貫性を得る方法です |
| 最初と最後のフレーム | ショットの両端 | 1つのショット。固定するのはポーズで、映像全体での同一性ではありません |
| マルチショット動画 | モデル自身が作るカットをまたいだキャスト | 1回の生成。次の生成ではまた最初からです |
| スタイルの一貫性 | ルック:表現手法、配色、粒子感 | 誰がショットに映っていても、映像全体 |
最初と最後のフレーム指定を使えば、あるショットの最後のフレームを次のショットの最初のフレームに引き継げます。つなぎ目はなめらかになりますが、ショット12はやはりショット3のことを知りません。
Veo、Kling、Seedanceのキャラクター参照
入り口は開発元ごとに違います。GoogleのVertex AIガイドでは、Veo 3.1に1人の人物、キャラクター、または商品の画像を最大3枚渡せ、Veoは動画の中で被写体の見た目を保つとしています。標準モデルでは、被写体画像を使って作るクリップの長さは8秒です。
Klingはキャラクターをエレメントとして作ります。そのElement Libraryガイドでは、1つのエレメントに画像を2〜4枚(メイン1枚と別の角度から最大3枚)求め、メインには正面向きの画像を推奨し、Kling 3.0は最大3つのエレメントを開始フレームに結びつけられるとしています。
Seedanceは一度に多くの参照素材を受け取りますが、ここで重要なルールが1つあります。BytePlusのSeedance 2.0シリーズのチュートリアルによると、これらのモデルは実在の人物の顔を直接含む参照画像や動画を受け付けず、代わりに独自のデジタルキャラクターと、許諾を得た実在人物の素材を提供しています。
よいキャラクター設定シートの条件
モデルは、望むかどうかにかかわらず参照画像に写っているものをコピーします。だからよい設定シートは、あえてシンプルにします:
- 正面、横、後ろのどの角度でも同じ顔と髪で、肌のトーンもそろっていること。
- 1枚の設定シートにキャラクターは1人。2つ目の顔は、借用されうる2つ目のアイデンティティになります。
- 落ち影や色かぶりのない無地の背景。あると、すべてのショットに出てきます。
- 文字、ラベル、数字を入れない。モデルがショットに書き込んでしまうことがあります。
- Klingの推奨どおり、はっきりした正面の姿をメインの画像にし、服装全体が見えるようにする。
- 場所は、キャラクターのいない専用の設定シートに。
ショットごとにキャラクターの顔が変わる理由
| 起きる理由 | 試すこと | |
|---|---|---|
| シーンごとに服が変わる | 服装が、あるショットの文章には書かれていて次のショットにはなかった、または参照画像になかった | 服装全体を設定シートに描き、すべてのショットで同じ言葉で指定する。 |
| 横や後ろからだと顔が違う | 参照画像が正面しか写していなかった | 横と後ろの姿もある設定シートを使うか、カメラをキャラクターの正面に保つ。 |
| ワイドショットで顔が失われる | 高さ数ピクセルの顔には、参照画像の情報がほとんど乗らない | 小さくても読み取れるもので人物を保つ:髪、色、スカーフ、帽子。 |
| 手、眼鏡、アクセサリーが変わる | 小さな細部はショットごとに生成し直され、左右も入れ替わりやすい | 細部とそれがどちら側にあるかを指定し、数を減らす。 |
| キャラクターが老けて、または若く見える | 光、メイク、表情で見た目の年齢が変わる | すべてのショットで年齢を言葉で書き、光を設定シートに近づける。 |
| 髪が伸びる、または短くなる | 長さが固定されておらず、動きにつれてずれる | 長さを正確に書く:「短い髪」ではなく「あごまでのボブ」。 |
| 2人のキャラクターが1人に混ざる | 似たキャラクターは、同じアテンションを通じて特徴を共有してしまう | ひと目で違いがわかるようにし、それぞれに専用の設定シートを用意する。 |
なぜショットの途中でキャラクターが変わるのでしょうか?それはクリップの中のずれで、時間的一貫性の破綻です。新しい参照画像よりも、短いショット、少ない動き、大きく振り向く前のカットのほうが効果があります。
AI動画で同じキャラクターを保つには:チェックリスト
- どのショットよりも先に、キャラクターを設定シートとして一度だけ作る。
- そのキャラクターが映るすべてのショットにその設定シートを渡すか、そこから作った画像で各ショットを始める。
- キャラクターを決定づけるいくつかの特徴を、すべてのプロンプトに一字一句同じに書く。
- できるだけ映像全体で1つのモデルを使う。参照画像の読み方はモデルごとに違います。
- 別々のショットの静止画を並べて比べる。動いていると見逃す変化も、静止画ならはっきりわかります。
実在の人物、肖像、同意
DreamBenchがすべてのショットでキャラクターを同じに保つ仕組み
作りたい映像を説明すると、DreamBenchは脚本を書き、1つのショットもレンダリングしないうちにキャストを描きます。すべてのキャラクター、場所、小道具を一度だけ設定シートとして描き、どのショットでも同じにします。「映っているのは誰ですか?」の下に画像を追加し、キャラクター、クリーチャー、ロケーション、小道具のいずれかとしてタグ付けすると、その設定シートはあなたの画像から、光や背景ではなく被写体だけを取り出して描かれます。以前作った設定シートはそのまま使われます。
設定シートを描く前に、各キャラクターと小道具にはアイデンティティロックが与えられます。顔、横顔、体、大きさをキャスト全員分まとめて書くので、2人のキャラクターが同じ顔になることはありません。そこから取った短い識別情報の一文が、そのキャラクターが映るすべてのショットに一字一句そのまま書き込まれます。サウンドを作るモデルではキャラクターの声も、さらに画面に映る人数も一緒に書かれます。
設定シートがショットにどう届くかは、モデルによります。Seedance 2.5、Seedance 2.0、Veo 3.1、Vidu Q2では、設定シートが参照画像として各ショットに添えられます。それ以外のモデル(Veo 3.1 FastとLite、Kling 3.0など)では、DreamBenchがまずショットの設定シートから冒頭の静止画を描き、ショットはその静止画から始まります。
雨でずぶ濡れになったキャラクターのように、ストーリーに必要な変化は、そのキャラクター自身の設定シートのバリエーションとして描かれます。確認することを選べば、何かを撮る前にキャストを確認でき、どの設定シートも描き直したり、自分の画像から描いたりできます。それでもうまくいかないショットは、直したい点をメモに書いて撮り直します。
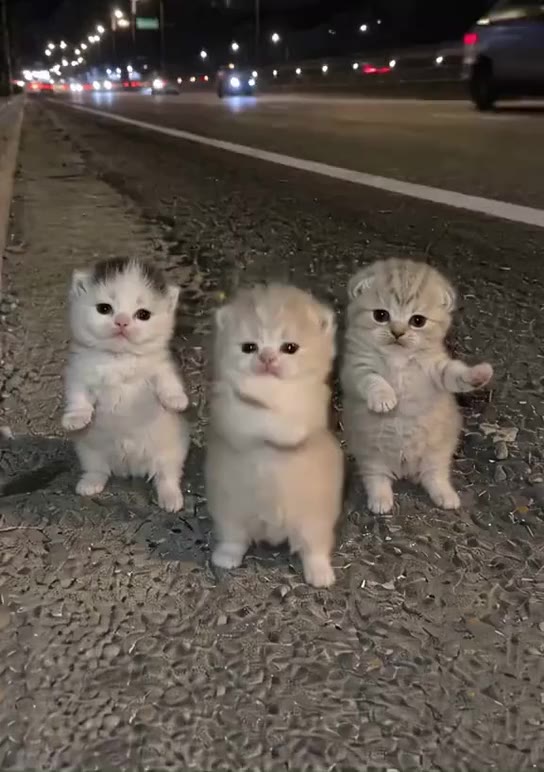 オリジナル
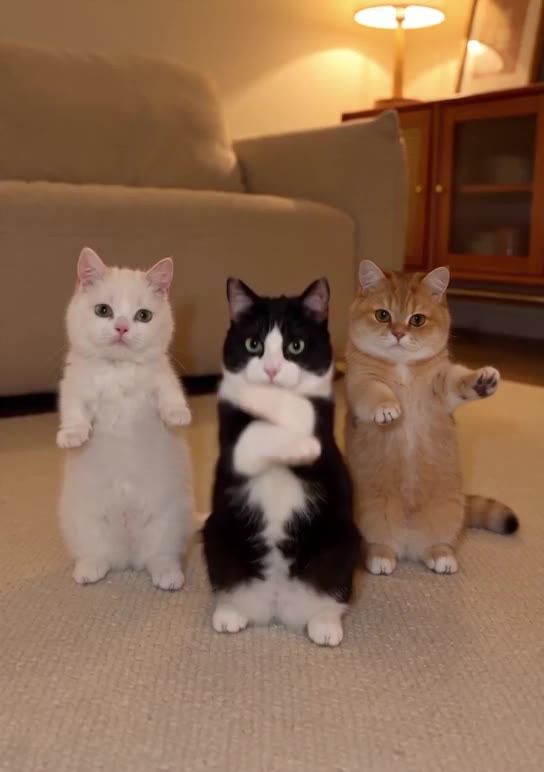 Morph版
背景を @livingroom に変えて @floorplan の配置どおりにし、3匹の猫を @yickshuncat、@oreo、@mango に差し替えてください。
よくある質問
AI動画で同じキャラクターを保つには?
AI動画で同じキャラクターを保つには、すべてのショットに同じ参照画像(できれば正面、横、後ろの姿があるキャラクター設定シート)を渡し、キャラクターを決定づけるいくつかの特徴をすべてのプロンプトに一字一句同じに書きます。各ショットは別々の生成なので、繰り返さないものはすべて作り直されます。
ショットごとにキャラクターの顔が変わるのはなぜですか?
ショットごとにキャラクターの顔が変わるのは、動画モデルが各ショットを一から生成し、前のショットのことを何も覚えていないからです。すべてのショットに同じ参照画像と説明がなければ、言葉に合う新しい顔を作り出します。横顔、後ろ姿、ワイドショットの小さな顔がいちばんずれやすくなります。
Klingで一貫したキャラクターを作るには?
Klingでは、一貫したキャラクターをエレメントとして作ります。KlingのElement Libraryガイドでは画像を2〜4枚(メイン1枚と別の角度から最大3枚)求め、一貫性を高めるにはメインを正面向きの画像にするよう勧めています。DreamBenchでは、Kling 3.0のショットは、キャストの設定シートから描いた冒頭の静止画から始まります。
AI動画のキャラクター設定シートとは何ですか?
キャラクター設定シートとは、キャラクターを複数の角度(通常は正面、横、後ろ)から描いた1枚の画像で、どの角度でも同じ顔、髪、服装で、無地の背景に描かれます。各ショットに参照画像として渡すので、キャラクターが振り向いたときの見た目がモデルにわかります。
同じシードを使えばキャラクターの一貫性は保てますか?
いいえ。同じシードでクリップが繰り返されるのは、プロンプト、長さ、フレーム、モデルが同じ場合だけです。新しいショットではそのうち少なくとも1つが変わるので、顔も変わります。キャラクターを保つのは参照画像と繰り返す言葉で、シードではありません。
キャラクターの一貫性と時間的一貫性の違いは何ですか?
時間的一貫性は1つのクリップの中の話で、各フレームが前のフレームと一致するかどうかです。キャラクターの一貫性はクリップをまたぐ話で、ショット2の人物がショット9でも同じ人物かどうかです。クリップが安定していても、違う人物が映っていることはあります。
一貫したキャラクターには参照画像が何枚必要ですか?
最低限ははっきりした正面向きの画像1枚で、同じキャラクターをいくつかの角度から写した画像があると、たいていよく保たれます。モデルが横顔や後ろ姿を知れるからです。Klingのエレメントは画像を2〜4枚受け取り、GoogleのVeo 3.1は1つの被写体の画像を最大3枚受け取ります。
自分の写真をAI動画のキャラクターに使えますか?
はい、実在の人物の顔を受け付けるモデルなら使えます。自分の写真は自分自身の肖像で、はっきりした正面向きの、均一に照らされた画像がいちばんうまくいきます。Seedance 2.0をはじめ、実在の人物の顔を受け付けないモデルもあります。DreamBenchでは、18歳未満の実在の人物が写っているように見える画像は拒否されます。
Seedanceが参照写真を拒否するのはなぜですか?
Seedanceは、参照写真に実在の人物の顔を読み取ると拒否します。BytePlusによると、Seedance 2.0シリーズのモデルは実在の人物の顔を直接含む参照画像や動画を受け付けず、代わりにプリセットのデジタルキャラクターと、許諾を得た実在人物の素材を提供しています。
シーンごとにキャラクターの服が変わるのはなぜですか?
シーンごとに服が変わるのは、参照画像やプロンプトに服装がなく、モデルがその場面に合うもので埋めるからです。服装全体を設定シートに描き、すべてのショットで同じように指定し、新しい服装には専用の設定シートを用意しましょう。
AIは同じシーンで2人のキャラクターの一貫性を保てますか?
はい、それぞれに参照画像があれば保てます。各キャラクターに専用の設定シートを用意し、プロンプトでそれぞれの名前を書けば、どの画像がどの人物かがモデルにわかります。似た見た目のキャラクターは混ざることがあるので、ひと目で違いがわかるようにしましょう。
DreamBenchは映像全体でキャラクターの一貫性を保てますか?
はい。DreamBenchは、どのショットもレンダリングする前に、すべてのキャラクター、場所、小道具を設定シートとして一度だけ描き、各キャラクターの識別情報をすべてのショットに一字一句そのまま書き込み、モデルに応じて各ショットに設定シートを参照画像または冒頭の静止画として渡します。
関連ページ
モデルのページ
用語
- 時間的一貫性AI動画が、ちらつきやずれなく、フレームからフレームへどれだけ同じものを同じに保てるか。
- 画像から動画へ静止画から始めて、プロンプトから動きを生成するAI動画。
- 参照画像から動画生成あなたの画像のキャラクター、商品、場所を、新しいショットでも見分けられる形で保つAI動画。
- 最初と最後のフレーム1枚の画像で始まり別の画像で終わり、その間の動きが生成されるAI動画。
- マルチショット動画複数のショットをカットでつないだAI動画。ショットリストとして計画し、1ショットずつ生成して、1本の映像につなぎます。
- ネイティブオーディオ動画モデルが映像と一緒に作る音。セリフ、効果音、環境音が1つのタイムライン上に。
出典
- 参照画像からVeo動画を生成するGoogle Cloud(に確認)
- Kling Element LibraryユーザーガイドKling AI(に確認)
- Dreamina Seedance 2.0シリーズのチュートリアル:人物動画を作成するBytePlus(に確認)
- IP-Adapter: Text Compatible Image Prompt Adapter for Text-to-Image Diffusion ModelsarXiv(に確認)
- InstantID: Zero-shot Identity-Preserving Generation in SecondsarXiv(に確認)
- DreamBooth: Fine Tuning Text-to-Image Diffusion Models for Subject-Driven GenerationarXiv(に確認)
- LoRA: Low-Rank Adaptation of Large Language ModelsarXiv(に確認)
- StoryDiffusion: Consistent Self-Attention for Long-Range Image and Video GenerationarXiv(に確認)
DreamBenchは独立したプラットフォームで、このページに登場する企業との提携や、それらの企業による推奨はありません。